过去一年,AI视频生成赛道的主旋律已经从“能生成画面”切换到“能不能一直生成下去”。但摆在行业面前的三座大山始终没有真正翻过去:长视频里的角色一致性、音画同步的可控性,以及用户能不能在生成内容里自由探索。就在大家还在用“拼接片段”硬撑长视频时,京东探索研究院在9月9日的京东全球科技探索者大会(JDD)上直接亮出了新牌:升级版 JoyAI-Echo1.5 长视频生成模型,以及全新开源的可交互音视频世界模型 EchoWM。前者把连续音视频生成时长推过了10分钟大关,后者则把原生音视频生成和用户操控捏在了一起——用更直白的话说,AI内容正在从“可看”走向“可进、可探索”。
长视频方面,这次 JoyAI-Echo1.5 的关键词是“记忆”。它基于音视频 Memory Bank 架构,在多机位、长时长生成过程中,能死死锁住角色形象、声音和故事线,支持连续产出超过10分钟的音视频内容。相比以往“生成几分钟就崩”的做法,这个思路明显是在向真正的“可播出”内容靠拢。更值得注意的是训练方式带来的效率红利:通过在长视频上训练,模型推理速度最高提升 7.5 倍,只需要 2 张 H200 就能以 480P 分辨率生成每秒 24 帧的画面,实现实时 1:1 生成;同时,导演智能体(Director Agent)可以通过自然语言完成从剧情构思、分镜规划、生成审核到最终合成的全流程。这意味着创作者不需要再一帧一帧去修,而是像指挥一个剧组一样去描述意图。
世界模型方向,行业里其实一直存在两条路线:一种是根据用户操作持续生成视觉画面,但缺少自然声音;另一种是能音视频联合生成,却很难让用户在长时间里持续做修改。EchoWM 的做法是直接把两种能力合到一起:生成包含 720P 视频、环境音、音乐和语音在内的原生音视频内容,声音会随着场景、镜头和主体的运动同步变化。通过统一的“相机意图”,它支持第一人称导航、第三人称相机与主体协作控制,以及多轮连续探索。在 WBench 导航评测中,EchoWM 和四步因果流式版本 EchoWM-Flash 拿下前两名,EchoWM 在覆盖 158 个多轮导航案例的榜单上位列综合第一。从评测结果来看,这种“能听、能看、能操作”的方向已经开始形成可量化的优势。
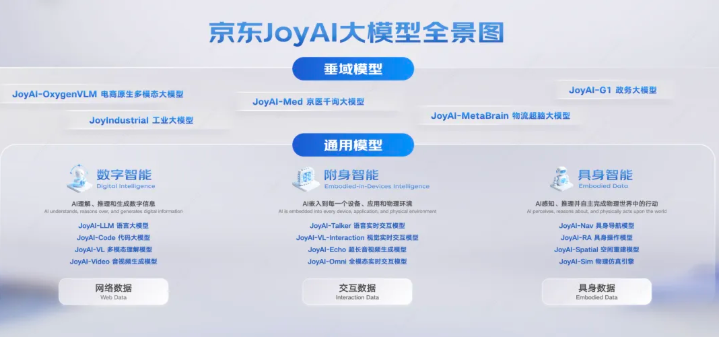
在更底层的基础模型层面,京东集中展示了 JoyAI 基础模型矩阵,覆盖图像视频生成、多模态理解、实时交互、世界建模、智能语音和具身操作,推动 JoyAI 从内容生成走向动态环境中的感知、仿真和交互。JDD 现场还演示了全新的音视频基础模型 JoyAI-Video,重点提升商用视频生成、物理规律表征、第一人称视角和多镜头连续叙事能力,目标直指电商广告、短剧创作和具身智能训练,预计10月正式发布。除了模型本身,京东还展出了 EgoLive 真实世界数据、JoyAI-Sim 仿真转化工具链和大模型基础设施,从真实数据、仿真转化到模型开发形成了一套完整的支撑体系。
客观来看,这次发布的真正价值不只是“又多了一个视频模型”,而是把长视频生成从“拼运气”推向“讲逻辑”:Memory Bank 解决一致性,Director Agent 解决可控性,EchoWM 解决交互性,JoyAI-Sim 解决数据来源。当然,也要冷静看到,10分钟以上连续生成的稳定度、音画同步在复杂场景下的表现,以及这些能力在真实商业场景中的成本控制,仍然需要大规模落地验证。但至少,京东这次给出的路径是明确的:AI生成内容的下一个战场,不只是更长的时长,而是更完整的“世界感”。