就在今天,通义千问的音频家族突然甩出一张王炸——Qwen-Audio-3.1系列一口气端出五个新模型,从语音识别、语音合成到实时交互、音频创作,直接按着价格地板摩擦。TTS降价约70%、Realtime降价约85%、ASR更是狂砍95%,这波操作让不少开发者直呼“真·白菜价”。要知道,去年行业还在为每千小时几百块的ASR成本头疼,现在一个模型直接把它打到了几块钱量级。卷完参数卷价格,这可能是音频AI走向规模落地的关键一枪。
五箭齐发,ASR价格杀到95% off
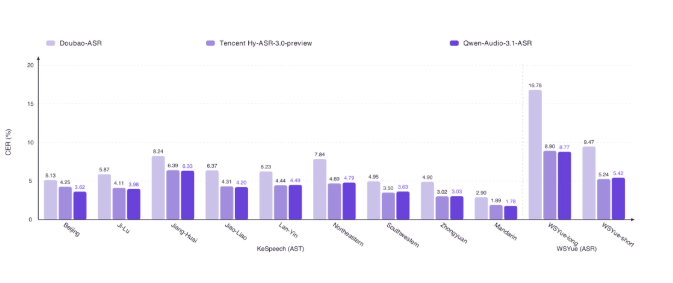
先看最核心的Qwen-Audio-3.1-ASR,这次升级直接给语音识别加上了“转写抛光”功能——自动去除语气词、重复表述,顺手把语义重新捋顺。角色化转录能精准标出“谁在什么时间说了什么话”,会议记录再也不用人工贴标签了。支持30种语言+16种中文方言,行业术语和热词也能按需配置,首字响应延迟约160毫秒,基本做到了“边说边出”。实测数据上,在KeSpeech和WSYue的11个子集上平均字符错误率(CER)仅4.55%,内部方言测试集CER为10.38%,AST语义句子准确率冲到82.10%——放在去年这成绩得挂个“旗舰”标,现在只是基础款。
紧接着的ASR-Next就更不讲武德了,直接把处理范围从“语音里的文字”扩大到“完整音频信息”。它能听懂情绪、环境声、机械声,还能做声音描述、事件定位甚至音频问答推理。在角色化ASR评测中,Flash-Next和Flash版本分别拿下5项和3项最佳,全面超越了之前的Fun-ASR级别系统。说白了,以前是“听清说了什么”,现在进化成“听懂发生了什么”。
语音合成这边,Qwen-Audio-3.1-TTS支持多语言和方言合成,同一个声音能无缝跨语种切换,用户还能通过指令控制情绪、语速和表达方式。而新出的TTS-Next更狠——通过统一理解文本、时间戳和参考音频,一次性生成人声、音效和环境声,输出可达48kHz,支持精细时间戳控制。播客、有声书、影视配音、游戏音效……一个人+一台电脑就能搞定整个音轨。
从听懂到创作,语音正在成为AI的天然入口
实时交互模型Qwen-Audio-3.1-Realtime采用全双工架构,可以边说边听、随时打断。它不光能识别文字,还能感知情绪和沟通意图——检测到用户情绪低落时,会自动放慢语速、调整措辞。支持实时多语言切换,对话过程中还能调用API、知识库和业务系统工具完成任务。基于多教师蒸馏架构,它在保持低延迟的同时强化了事实可靠性和安全边界。说人话就是:你不会再听到它瞎编答案了。
纵观整个系列,从“听清”到“听懂”再到“会创作”,Qwen-Audio-3.1其实在重新定义语音模型的边界。此前行业里语音和文本、音频内容创作往往是割裂的,而这次通义把所有能力揉进一个栈里,并且用价格战逼着同行跟进。对开发者而言,95%的成本下降意味着语音交互可以像调用API一样随意;对普通用户来说,以后可能对着手机哼两句就能生成一段配乐、录一段会议录音就能导出结构化纪要。语音,正在从“输入方式”变成“交互界面”甚至“创作工具”。这波操作,值得所有关注AI应用落地的人多看两眼。