每天用 AI 编程助手,token 账单正在悄悄烧你的钱
如果你每天都在用 Claude Code、Cursor、Codex 这类 AI 编程智能体,大概率遇到过这两件事:一是上下文爆了——一个稍大点的仓库探索几轮,token 窗口就塞满了,智能体开始失忆、瞎改;二是账单肉疼——那些又臭又长的工具输出(动辄几万 token 的日志 dump、JSON 结果)原样塞进模型,花的全是真金白银。
解决思路其实很直接:在数据送进模型之前,先把“废话”压掉,关键信息一字不差地保留。 今天要分享的开源项目 Headroom,就是干这件事的,而且是今天(2026-10-22)GitHub Trending 上的热门项目。
它是什么:AI 智能体的“上下文压缩层”
Headroom(仓库 headroomlabs-ai/headroom,Apache 2.0 开源)给自己定的位是“the context compression layer for AI agents”——AI 智能体的上下文压缩层。它不是又一个智能体,而是一个插在你的智能体和 LLM 之间的中间层:智能体读到的所有东西——工具输出、日志、文件、RAG 片段、对话历史——先经过它压缩,再发给模型。
核心亮点有这么几个:
1. 压得狠,答案不变。 官方给出的数据是:coding agent 场景平均省约 20% token,JSON 类结构化数据能压掉 60%~95%。仓库 README 里还贴了四项可复现的实测:代码搜索省 21%、SRE 故障排查省 57%、代码库探索省 42%、GitHub issue 分拣省 30%。注意一个细节:它用不同策略对付不同内容——JSON 用 SmartCrusher、代码用 AST 感知的 CodeCompressor、散文用自家训练的 Kompress-v2-base 模型(已发布在 HuggingFace),而不是一刀切地删字。
2. 压缩在本地跑,隐私不出机器。 这是它和一众“云端压缩 API”最大的区别。整个压缩流程在你自己电脑上完成,prompt 和文件内容不会为了压缩而发给任何第三方。结合现在大家对代码隐私的敏感度,这个设计很加分。
3. 压缩可逆,丢不了关键信息。 压缩最怕的就是把关键行压没了——比如日志里那一行 FATAL。Headroom 的做法是:原件缓存在本地(CCR 机制),模型如果需要全文,可以按需取回。官方演示里,一个 10,144 token 的日志 dump 压到 1,260 token,而 FATAL 那一行逐字节保留。
4. 四种接入方式,零代码也能用。 可以当 Python/TypeScript 库直接 compress(messages);可以起一个本地代理 headroom proxy --port 8787,任何语言零改代码;最省事的是 headroom wrap claude——一条命令把你现有的智能体包一层,Claude Code、Codex、Grok、Cursor、Aider、Copilot、OpenCode、Cline、Continue、Goose 等十几款都支持,headroom unwrap 随时还原;另外还提供 MCP 服务器,给 MCP 客户端用。
5. 附带两个“增值功能”。 一是跨智能体共享记忆(Claude、Codex、Gemini、Grok 共用一份带去重的记忆库);二是 headroom learn,能从失败的会话里提炼教训,自动写进 CLAUDE.local.md / AGENTS.md / GEMINI.md。另外它还能压“输出侧”token(模型写回来的废话),不过默认关闭,需要手动开。
截图导览
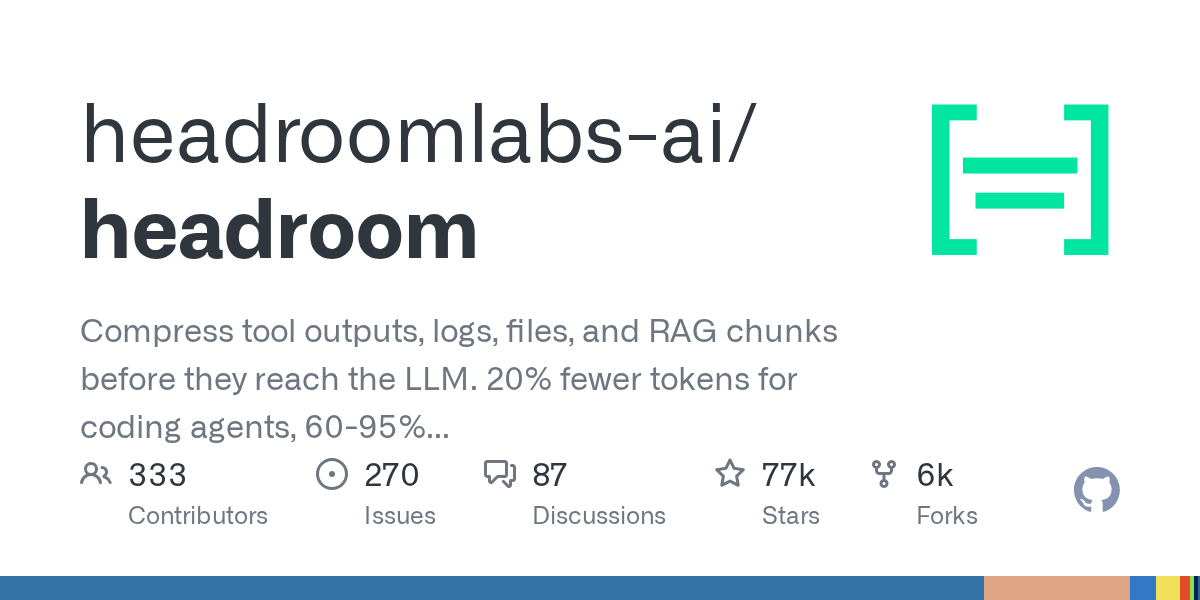
图注 1:Headroom 的 GitHub 仓库信息卡(headroomlabs-ai/headroom)。项目简介、77k star、6k fork、333 位贡献者一目了然——star 数是判断项目热度的第一手证据(2026-10-22 数据)。
图注 2:README 里的官方演示动图。展示一个 10,144 token 的日志被压缩到 1,260 token 的全过程,关键的 FATAL 报错行被完整保留——这正是“压得狠但不丢信息”的直观证明。
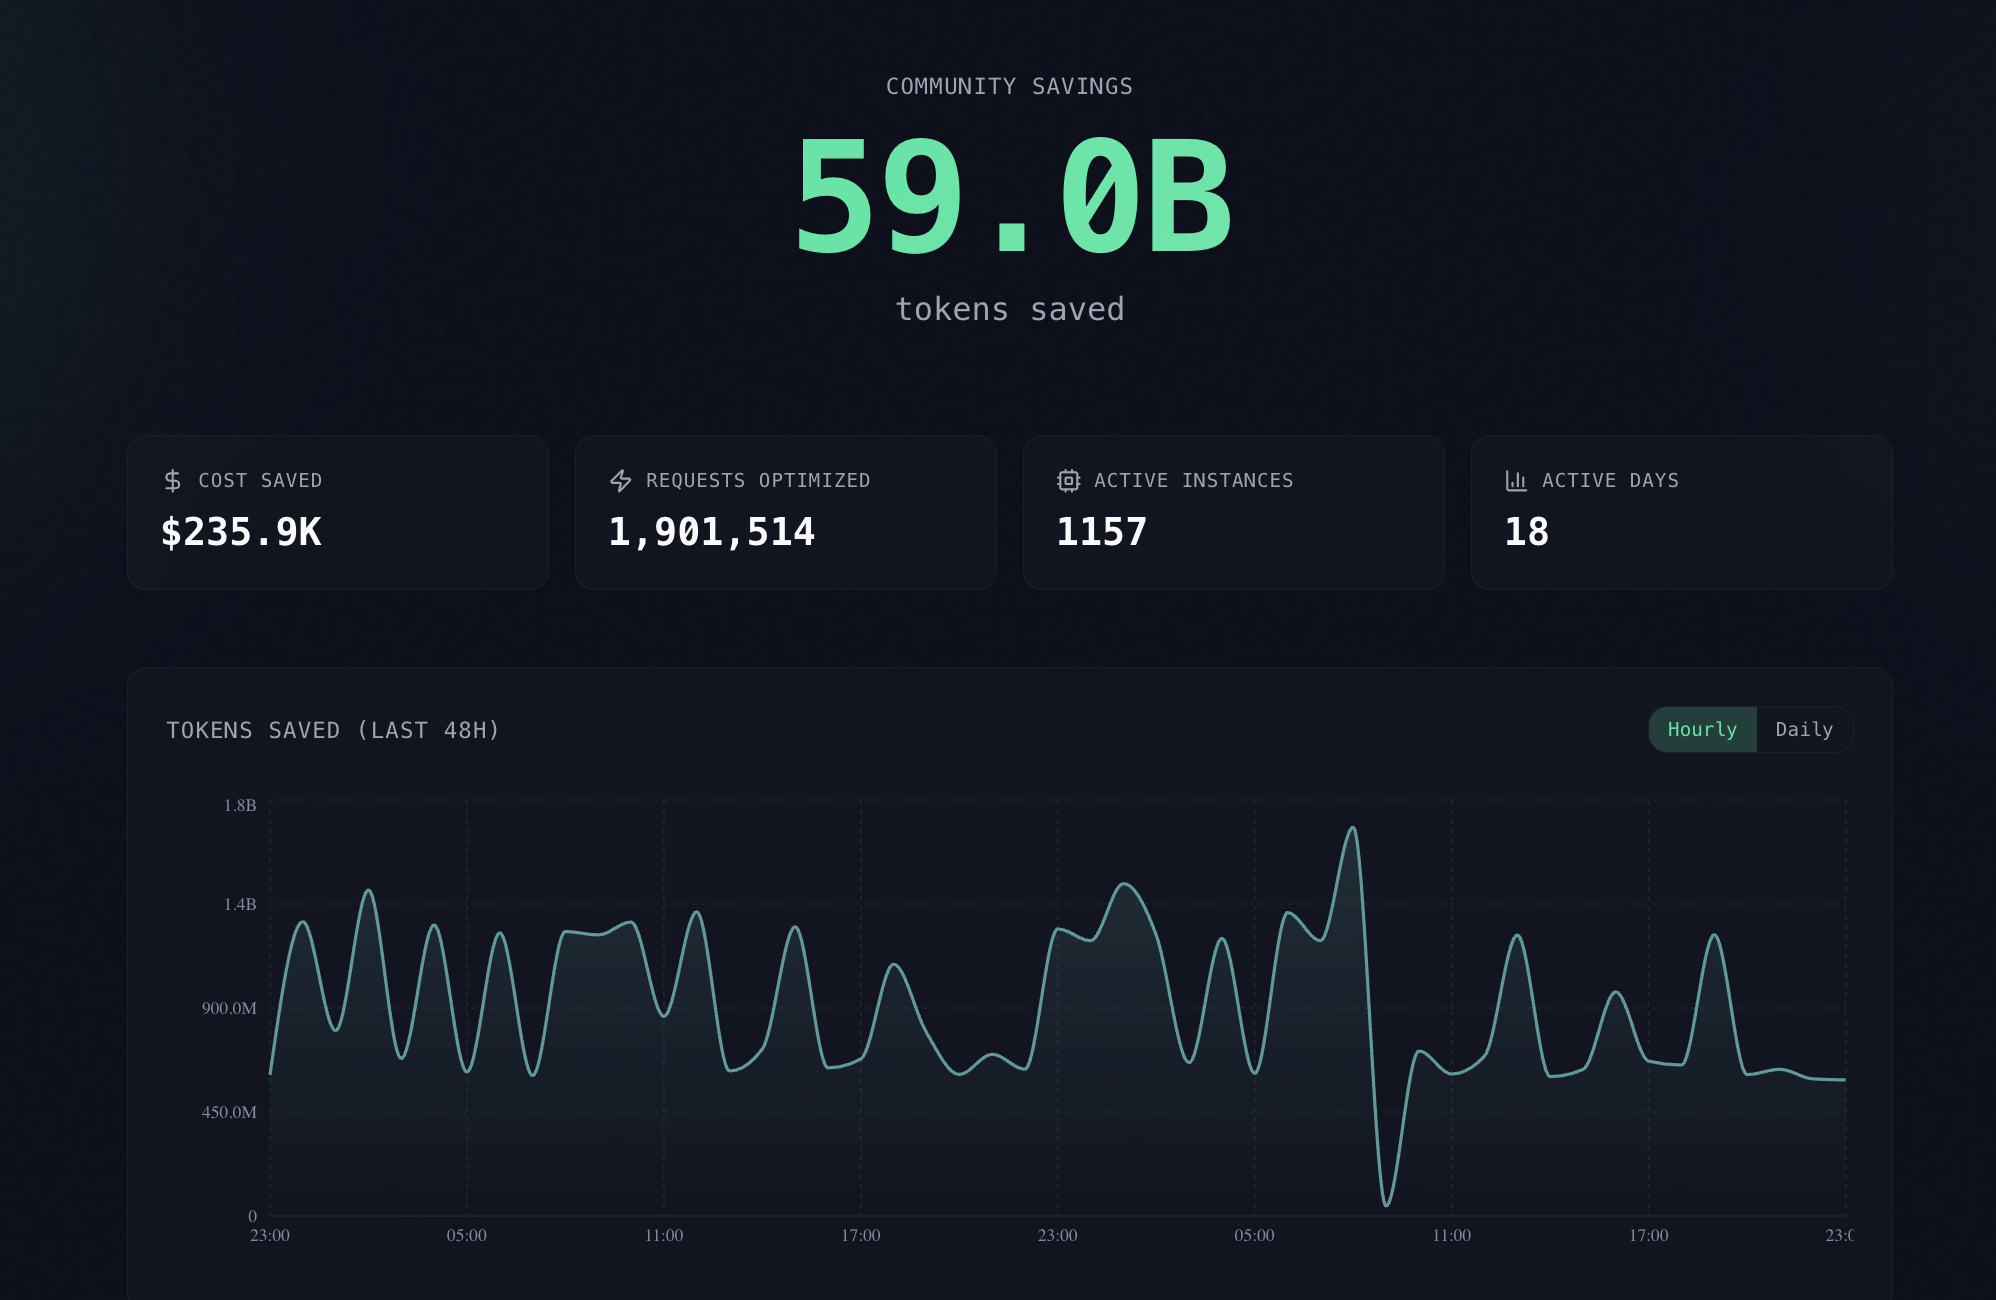
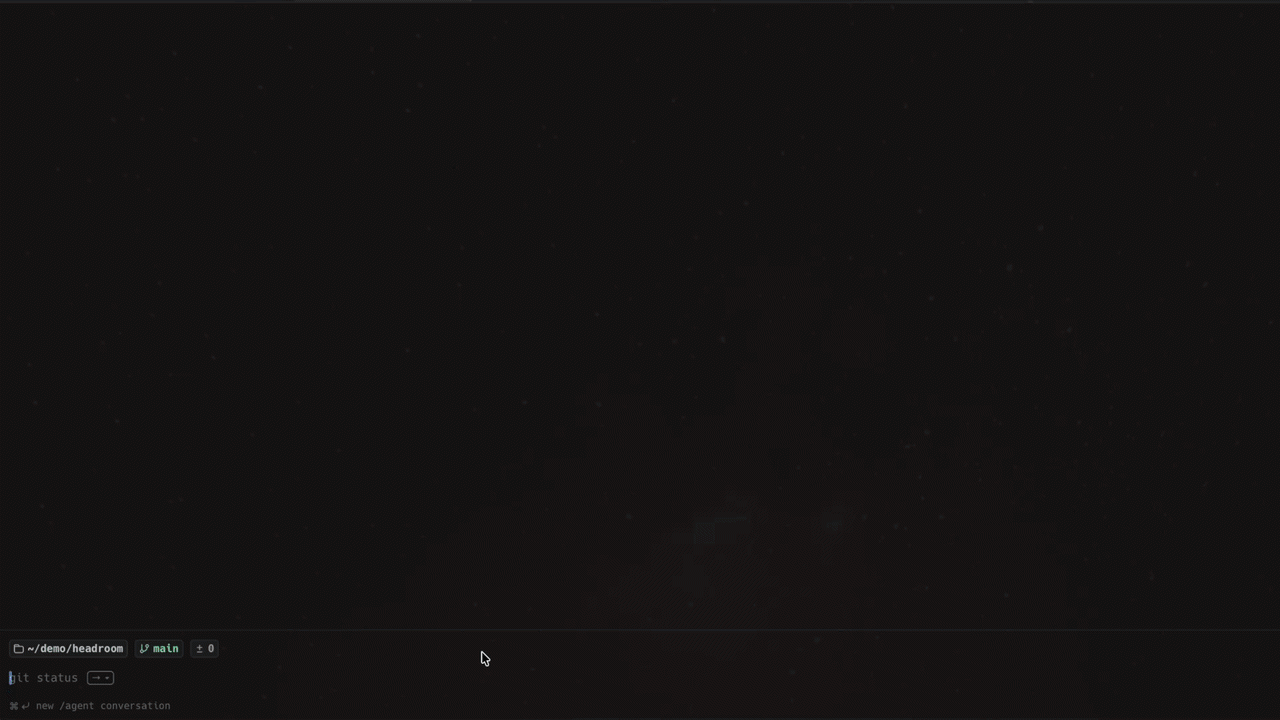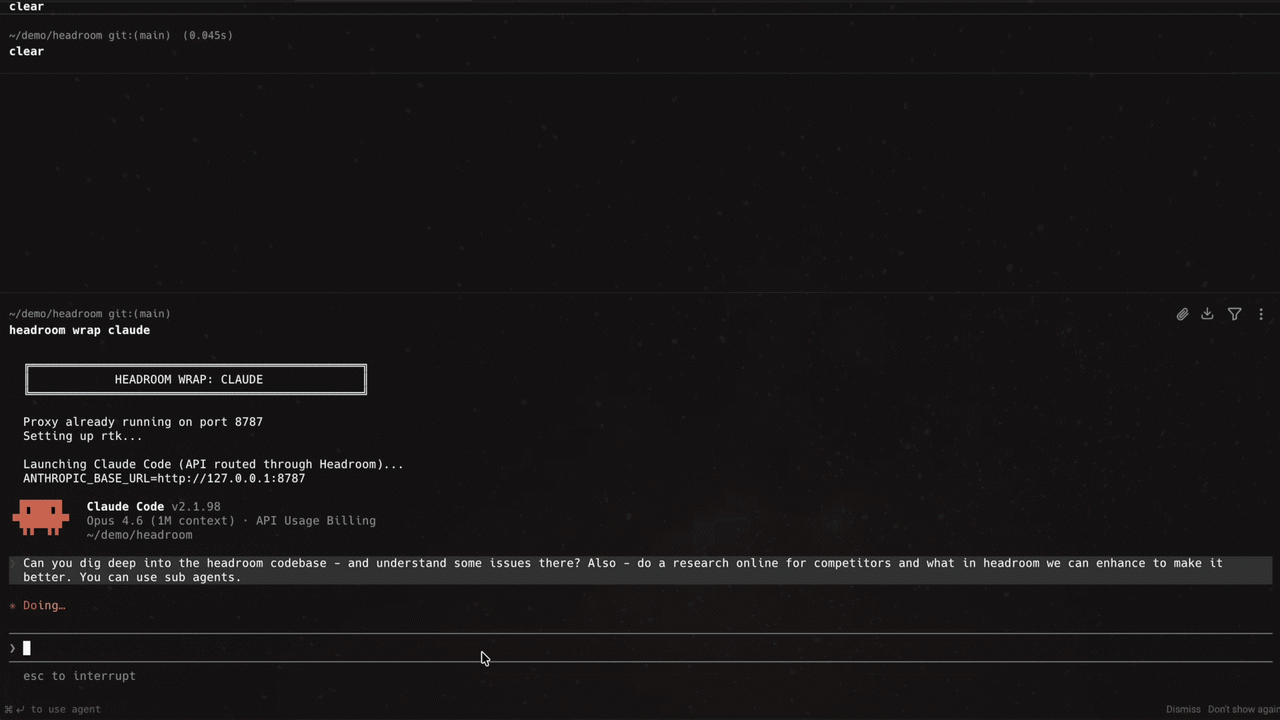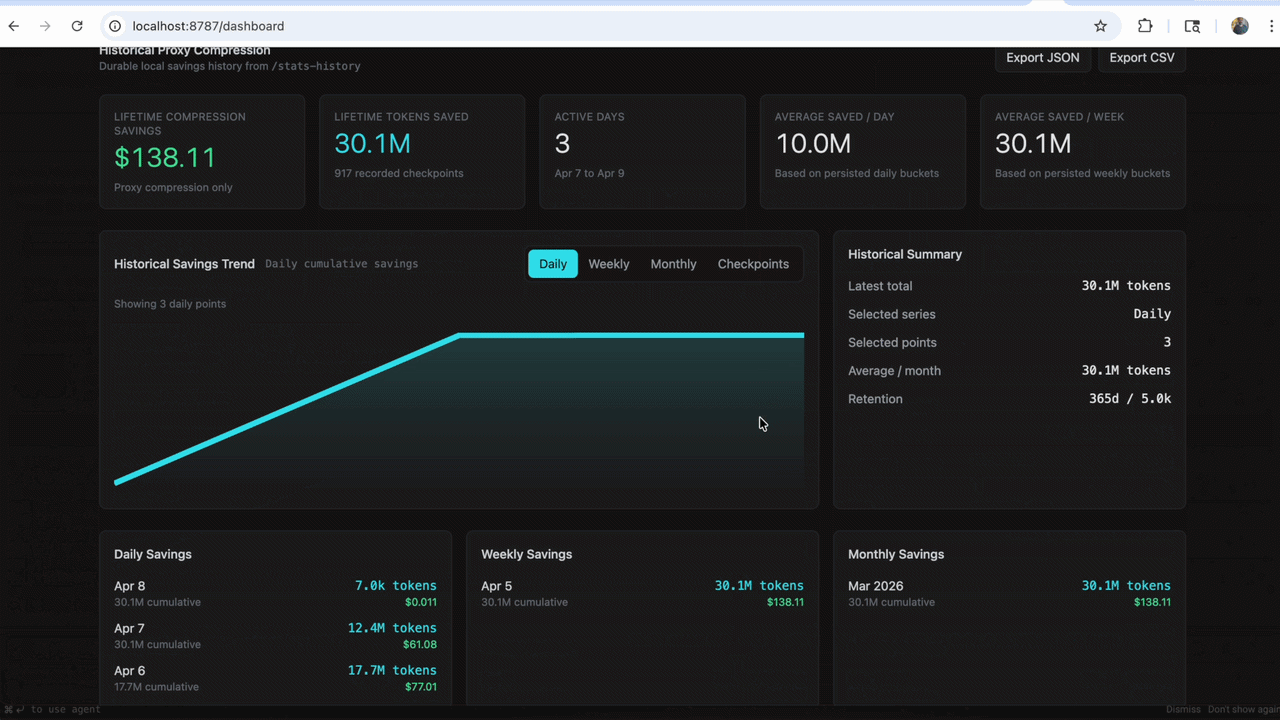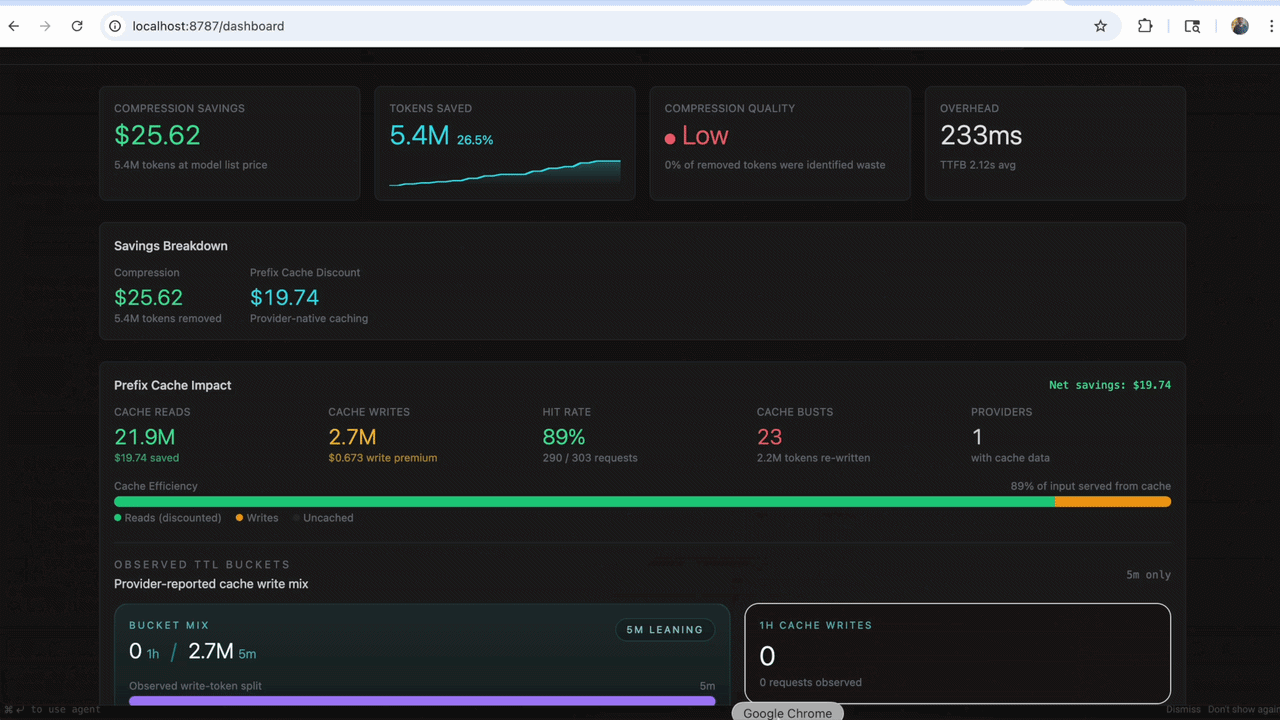
图注 3:Headroom 的社区节省看板(官方 README 展示)。累计为社区省下 590 亿 token、约 23.6 万美元 API 成本,190 万次请求被优化——省 token 不是纸面数字,是真实跑出来的账单。
快速上手:60 秒跑起来
按 README 的官方步骤,整个过程分三步:
第 1 步:安装。 任选其一:
uv tool install --python 3.13 "headroom-ai[all]"   # 推荐:隔离环境装 CLI
pip install "headroom-ai[all]"                     # Python 用户
npm install headroom-ai                            # 仅 TypeScript SDK(无 CLI)
门槛说明:需要 Python 3.10+;不需要 GPU(压缩是毫秒级的本地计算);Intel Mac 用户注意暂无原生 ONNX 轮子,建议走 Docker。Headroom 本身不需要任何 API key。
第 2 步:选一种模式。 最省事的是直接包一层你正在用的智能体:
headroom wrap claude        # 把 Claude Code 包一层
headroom proxy --port 8787  # 或者起本地代理,零代码改动
注意:wrap 默认把 OpenAI 兼容流量指向上游 api.openai.com,如果你用 DeepSeek / OpenRouter 等第三方兼容接口,记得按 README 加 --openai-api-url 参数,否则 key 会被送错地方报 401。
第 3 步:验证效果。
headroom doctor      # 健康检查,确认链路通了
headroom dashboard   # 实时看省了多少 token(代理模式下)
想先看“对我到底能省多少”,跑 headroom savings 对你自己的真实流量测一遍,比看官方基准数字靠谱。
我的建议:适合谁、不适合谁
适合谁: ① 每天重度使用 AI 编程智能体的人——上下文越长、工具输出越臃肿,省得越多,SRE 排查、代码库探索这种“日志满天飞”的场景收益最大;② 同时用好几款智能体的人——跨智能体共享记忆这一个功能就值回票价,不用在每个工具里重复“调教”;③ 对代码隐私敏感、不想把仓库内容发给第三方压缩服务的人——本地压缩是硬优势;④ 想控制 API 账单的团队——README 里甚至还有企业版,但开源版对个人开发者已经够用。
不适合谁: ① 只是偶尔问两句代码问题、会话都很短的人——README 自己也承认,短对话、散文、已经很密的数据基本压不动,别指望有体感;② 在沙箱/受限环境里跑不起本地进程的人;③ 只用某一家的原生“对话压缩”且不跨工具的人,可能觉得多一层代理是负担。
值不值得试:值得,但先花 5 分钟做两件事。 第一,跑 headroom savings 看你自己的真实节省率——官方 20%~95% 是“看场景”的数字,你的场景只有你自己能验证。第二,关掉默认开启的匿名遥测(HEADROOM_BEACON=off),虽然它只上报压缩统计、不发你的代码内容,但“默认开”这件事本身值得你亲手做一次选择。另外提醒一句:项目更新非常快(昨天刚有 commit),headroom update 可以原地升级,跟着新版本走就行。
一句话总结:Headroom 是给 AI 编程智能体省 token 的“本地压缩中间层”,压得狠、可逆、不碰你的隐私,重度用户闭眼试,轻度用户先测再说。
GitHub 仓库:https://github.com/headroomlabs-ai/headroom(Apache 2.0 开源,77k star,2026-10-22 数据)