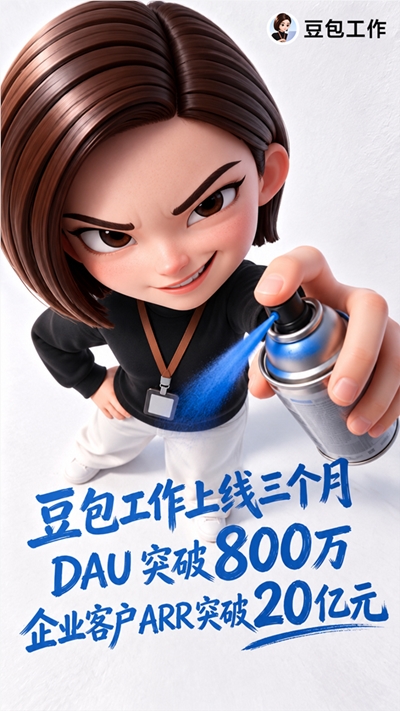
当大模型赛道从参数竞赛转向商业落地,谁能率先跑通面向企业的付费闭环,就成了行业关注的焦点。11月18日,豆包官方披露了其生产力AI产品“豆包Work”的最新商业化进展:上线仅三个月,日活跃用户(DAU)突破800万,企业客户的年度经常性收入(ARR)超过20亿元。这个数据放在当前国内AI原生应用普遍面临增收不增利的背景下,显得尤为扎眼。
追溯来看,豆包Work自8月25日正式发布后,一直锚定专业办公场景进行产品打磨。一个关键节点是11月16日上线的“工作台”功能——它一开始就覆盖了金融、医疗、教育、创意设计等21个垂直专业领域。通过预设行业专属的技能和工具包,企业用户无需从零配置即可快速接入,同时开放了自定义工作台的创建、保存与分享权限,让组织内部的协作流程得以固化并复用。这种“开箱即用+灵活编排”的思路,本质上是在降低AI办公的认知门槛和部署成本。
更值得关注的是底层模型生态的开放态度。豆包Work近期正式告别单模型绑定,接入了包括Kimi、GLM、DeepSeek在内的主流第三方大模型,并在前端清晰标注每个模型的额度消耗倍数,允许企业和个人用户根据任务复杂度与算力成本自主调配。这种“多模型路由”的设计,本质上是把选择权交给场景——简单任务用轻量模型省钱,复杂推理调用强模型保效果,算力成本与模型能力之间找到了一个动态平衡。
综合来看,在行业从“大模型能力秀”转向“高频生产力场景落地”的当前拐点,豆包Work“垂直场景工作台+自由多模型调度”的组合策略,有效降低了企业采用AI的门槛和持续使用成本。而20亿ARR这个数字,不仅验证了办公领域对生成式AI的真实付费意愿,也为国内AI原生应用探索规模化商业闭环提供了一份值得拆解的样本。接下来,能否在更多长尾场景中复制这个模型,以及如何应对竞品日益相似的功能跟进,将是豆包Work下一步需要回答的问题。