就在今天,智谱悄然上线了新一代模型 GLM-5.3-FlashX,官方标称的极限速度达到了惊人的每秒 200 tokens。这个速度意味着什么?对于企业开发者而言,几乎可以实现“边想边答”的实时交互体验,彻底告别过去“想半天才出一句话”的尴尬等待。在如今大模型应用从“能用”迈向“好用”的关键阶段,推理速度的提升,其价值丝毫不亚于模型智能水平的进步。
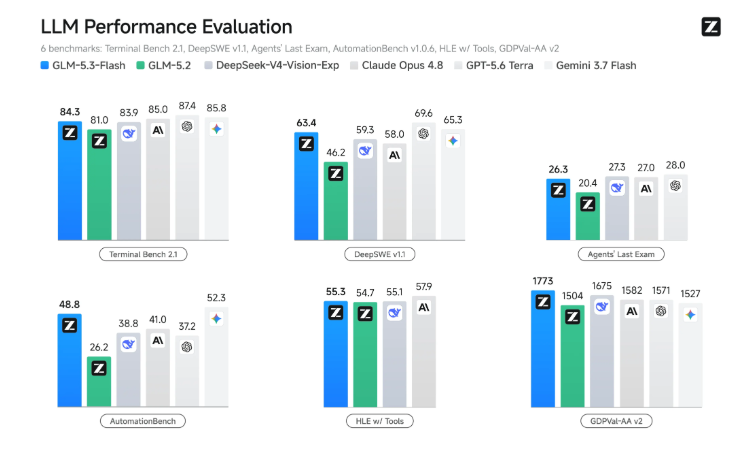
这款高速版模型并非凭空出世,其内测代号“Ox Alpha”已在海外开发者圈中掀起了不小波澜。它脱胎于此前发布的 GLM-5.3-Flash 基础版本,在同等参数量级下,凭借更为出色的“智力”表现赢得了全球开发者的青睐,导致API调用量一度飙升。面对急剧膨胀的算力需求,智谱选择了一条“硬扛”的道路:在基于10万张国产芯片支撑的算力底座上,持续对Infra基础设施和推理管线进行深度优化。最终交出的FlashX,不光是跑得快,更难得的是实现了“智能、价格、速度”三张牌的同时握在手中。这种“既要又要还要”的平衡,在目前国内的基座模型市场中,实属罕见。
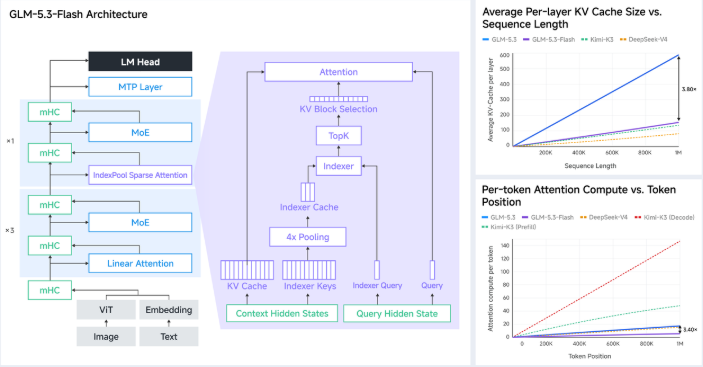
客观来看,这一动作释放了两个关键信号。其一,国产芯片集群在训推一体化方面的工程化能力正在快速走向成熟,不再只是“纸面数据好看”;其二,大模型竞争的下半场,已经从单纯的“暴力堆参数”转向了“体验为王”,谁能在低成本、高速度、强智能的三角关系中找到最优解,谁就能在这场马拉松中抢到下一个补给点。对于正苦于模型响应延迟、又对推理成本敏感的企业用户来说,GLM-5.3-FlashX的出现,也许正是那个开启新阶段的钥匙。
免责声明:本网站内容主要来自原创、合作伙伴供稿和第三方自媒体作者投稿,凡在本网站出现的信息,均仅供参考。本网站将尽力确保所提供信息的准确性及可靠性,但不保证有关资料的准确性及可靠性,读者在使用前请进一步核实,并对任何自主决定的行为负责。本网站对有关资料所引致的错误、不确或遗漏,概不负任何法律责任。任何单位或个人认为本网站中的网页或链接内容可能涉嫌侵犯其知识产权或存在不实内容时,可联系本站进行审核删除。