想给视频配音、做有声书,为什么非要按字符给云端交钱?
做短视频、播客、有声书的朋友大概率都算过这笔账:ElevenLabs 这类云端 TTS 按字符收费,量稍大一点就是一笔持续开销;更关键的是,声音数据要上传到别人服务器——克隆自己的声音、处理未公开的稿件,心里总归不踏实。开源圈不是没有本地 TTS,但大多是”能跑就行”的命令行工具:装一堆依赖、调一堆参数,做完一个 demo 就吃灰了,离”真正拿来干活”还差一截。
今天分享的 VoiceStudio 想解决的正是这个断层:一个开箱即用的桌面应用,把声音克隆、视频配音、转录、有声书做成普通人能点开就用的工作台,而且全程在你自己电脑上跑。 它是今天 GitHub Trending 上的热门项目(debpalash/VoiceStudio),半年时间攒下 8 万多 star,昨天(2026-10-22)还在更新。下面按我看 README 和仓库一手信息的理解,拆开讲讲它到底行不行、适合谁。
它是什么:你电脑上的”声音工作室”
VoiceStudio 给自己的定位是”open-source, fully-local ElevenLabs alternative”——开源、完全本地的 ElevenLabs 平替。注意”fully-local”这个词:它的卖点不是”又一个 TTS 模型”,而是一整套在你本地硬件上跑完的音频工作流。核心亮点有这么几个:
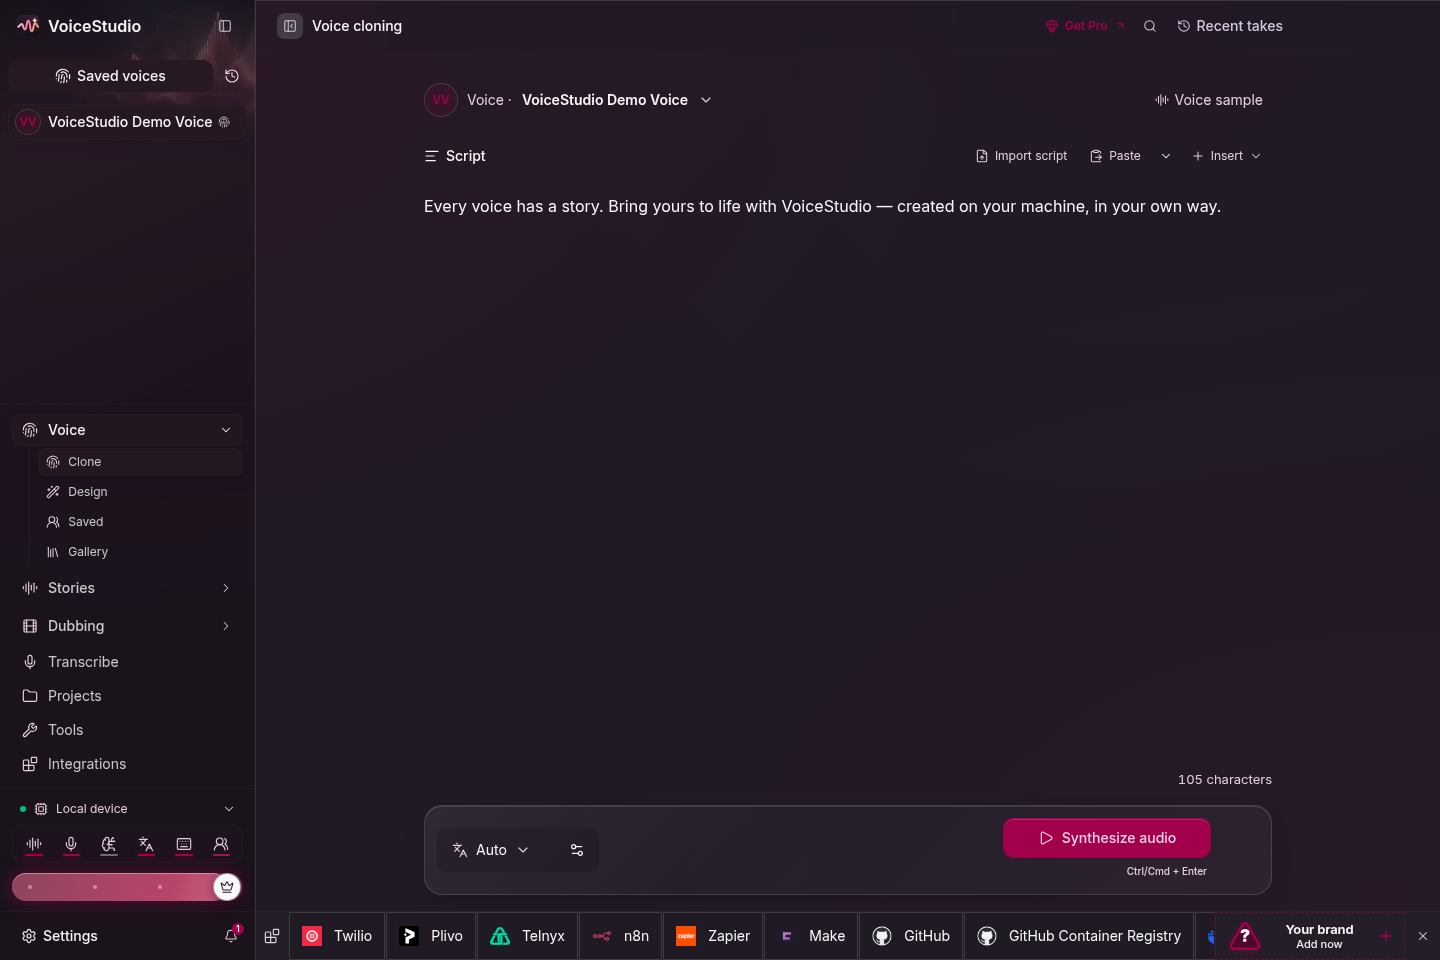
1. 声音克隆:给一段干净录音,就能”借”这个声音说话。 这是 ElevenLabs 的看家功能。VoiceStudio 的做法是:在克隆工作区选一个声音(自带演示声音),或上传一段干净的参考录音,输入文本就能生成。仓库特别强调了”责任使用”——只能克隆获得授权的声音,这一点后面建议里还会提到。
2. 声音设计:用文字描述”捏”一个不存在的声音。 不想用真人声音?可以直接描述想要的音色(比如”低沉的男中音,语速偏慢”),让它生成一个全新的声音。这对做播客、游戏解说、广告配音的人很实用——不用再去声音素材库里大海捞针。
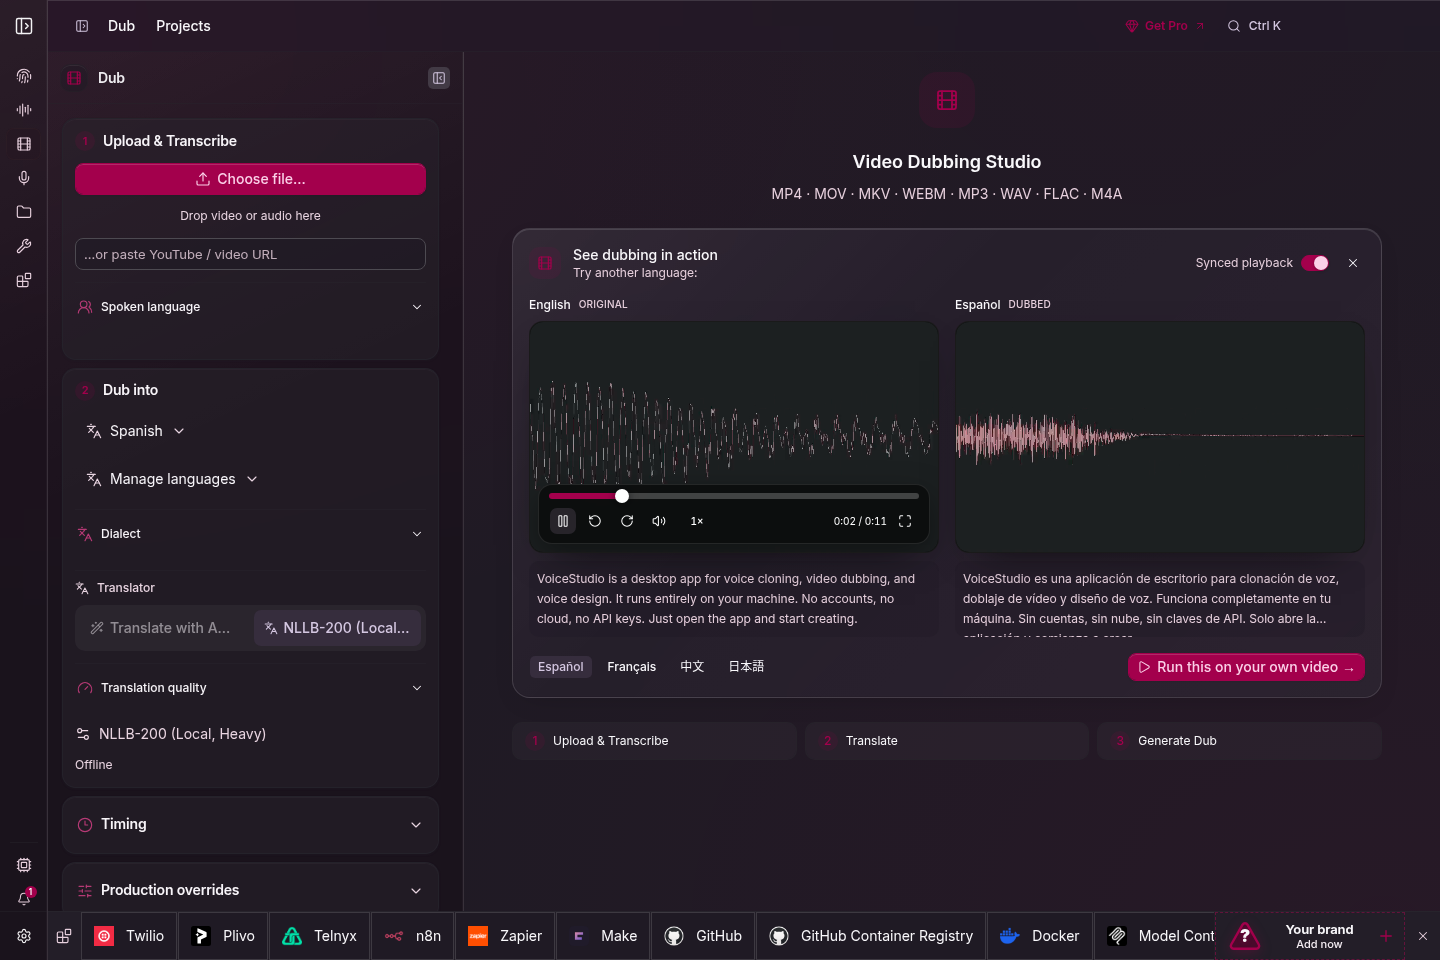
3. 视频配音:带时间轴对齐,不是简单念稿。 配音工作区支持给视频配上”timed speech”——语音和视频时间轴对齐。做影视解说、给英文视频做中文配音、外语教学视频本地化,这个功能是刚需。很多本地 TTS 工具只管生成音频不管对轴,VoiceStudio 把这一步收进了工作流。
4. 不止 TTS:听写、转录、有声书一条龙。 除了生成,它还吃”输入”:悬浮窗听写(说话直接转文字)、音频转录、故事和有声书的批量任务,还支持可复用的”配方”和监听文件夹——丢一堆稿件进去自动批量生成。对自媒体批量生产音频内容的人来说,这是省时间的关键设计。
5. 给 AI 智能体留了接口:本地 API 与 MCP。 这是它区别于传统桌面软件的一点:提供本地 API 和 MCP 服务器,Claude Code、Cursor、Codex 这类 coding agent 可以直接调用它的音频能力(比如让智能体自动给生成的视频配音)。README 里甚至给了让智能体”一键代装”的提示词模板,还支持 npx skills add debpalash/VoiceStudio 接入 Agent Skills 生态。
截图导览
快速上手:一条命令装完,门槛主要看硬件
安装是 VoiceStudio 做得最”不像开源项目”的地方——出奇地简单:
macOS / Linux 用户一条命令:
curl -fsSL https://voicestudio.sh/install | sh
Windows 用户在 PowerShell 里跑:
irm https://voicestudio.sh/install | iex
不想用脚本,也可以去 GitHub Releases 页面直接下载安装包(macOS 的 .dmg、Windows 的 .exe、Linux 的 .AppImage 或 .deb)。
真正的门槛在硬件,README 给了一张很实在的对照表,我直接翻译过来:
- 有 NVIDIA 显卡(Windows/Linux): 最佳体验,CUDA 加速,做配音、批量有声书都快。
- Apple Silicon 的 Mac: Metal(MPS)加速,M 系列芯片跑本地语音模型完全够用,这是很多个人创作者的主力机。
- 只有核显 / 老电脑: 纯 CPU 也能跑,但速度明显慢;安装时会自动装 CPU 版 PyTorch,需要预留约 5GB 磁盘空间。我的判断:偶尔用用可以,当生产力工具会很煎熬。
- Intel 芯片的 Mac: 注意,只能跑 App 界面,推理要连远程后端——手里是 Intel Mac 的可以直接劝退本地版。
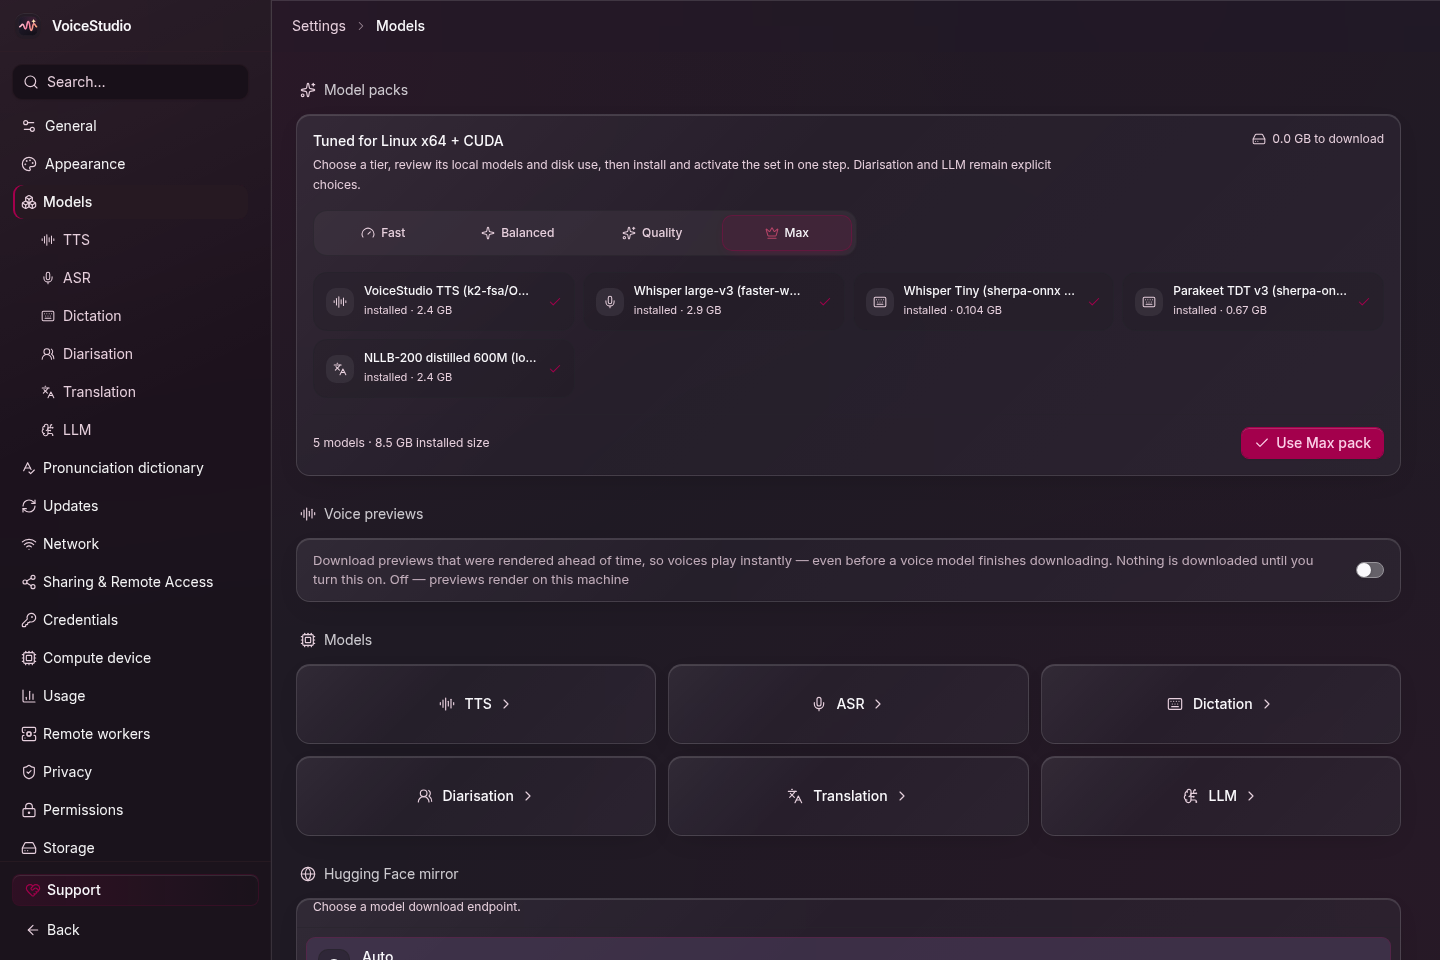
装完之后的使用流程也很直白:打开「Voice cloning」,选自带演示声音或上传一段干净的参考录音,输入文本,按提示把需要的模型下载下来(模型是按需安装的,不是装完 App 就全有了),点生成即可。全程不需要注册账号、不需要 API key,远程服务是可选项。这点对在意隐私的人是决定性优势:你的声音、你的稿件,不出你这台机器。
我的建议:谁该试,谁先别折腾
先说结论:如果你经常要做配音、播客、有声书类工作,且电脑带 NVIDIA 显卡或用 M 系列 Mac,VoiceStudio 值得花一个下午试试;如果你只是偶尔玩一下 TTS,或者电脑是 Intel Mac / 纯核显老机器,先别急着装。 理由拆开说:
适合这三类人。第一,做视频和播客的创作者。 视频配音(时间轴对齐)+ 批量有声书任务 + 监听文件夹自动处理,这套组合拳是冲着”生产”去的,不是 demo 玩具。ElevenLabs 按字符收费,做长视频/有声书成本线性增长,本地跑一次装好就是零边际成本。第二,在意数据隐私的人或团队。 声音是最敏感的生物特征之一,克隆自己的声音还把音频传云端,本身就有风险;未公开的商业稿件同理。fully-local 意味着这条风险链直接掐断。第三,想给 AI 工作流加语音能力的开发者。 本地 API + MCP 的设计,让智能体可以编排”写稿→配音→剪视频”整条链路,这是纯云端 TTS 方案不容易低成本做到的。
这三类人先别折腾。第一,Intel Mac 用户——README 写得很清楚,只能跑 UI,推理得连远程后端,本地化的核心优势你吃不到。第二,只有核显的老电脑——CPU 能跑但慢,批量任务会等到怀疑人生,不如先用云端方案顶着。第三,想直接商用的——注意许可证是 AGPL-3.0,应用本身的商业使用要遵守其条件(比如网络服务形式的分发有源码义务),而且模型权重、声音的授权是另算的;拿去做商业产品前,务必读一遍仓库的 License 章节,别想当然。
还有两点实在话。一是”平替”这个词要打折听。 仓库自称 ElevenLabs alternative,但 README 里没有给出和 ElevenLabs 的横向音质对比数据,646 种语言也是仓库自述。我的看法是:把它当”本地化、零成本、可私有部署的可用方案”,而不是”音质全面超越 ElevenLabs”——后者目前没有证据。二是声音克隆的伦理红线。 仓库明确要求只能克隆获得授权的声音。这不是摆设:用它克隆他人声音做欺诈或恶搞,在很多司法管辖区是违法的。技术无罪,用法有罪,自己掂量。
总的来说,VoiceStudio 代表了一个清晰的趋势:过去只有云端大厂能做好的事(高质量 TTS/声音克隆),正在被开源社区搬到本地。 半年 8 万 star、昨天还在更新,说明这不是一阵风。如果你正好在”云端 TTS 账单”和”数据隐私”之间纠结,它是目前最值得试的本地选项之一。
GitHub 仓库:github.com/debpalash/VoiceStudio(AGPL-3.0 开源,官网 voicestudio.sh)。建议 star 之前先看一眼 README 的硬件对照表,确认自己的机器跑得动再动手。