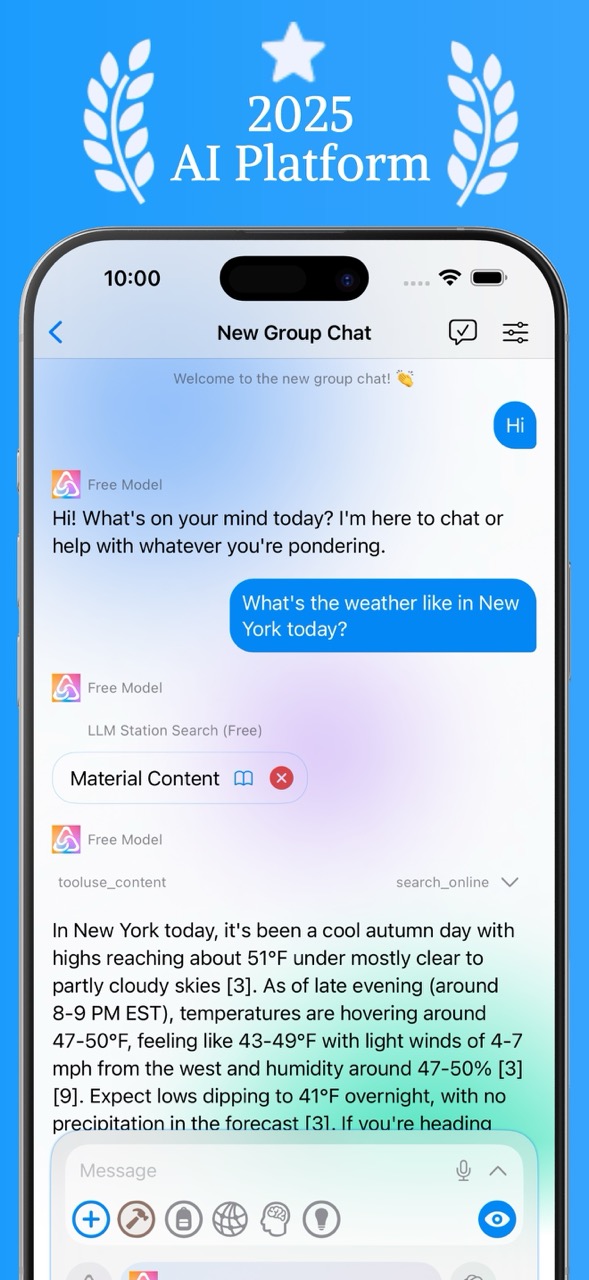
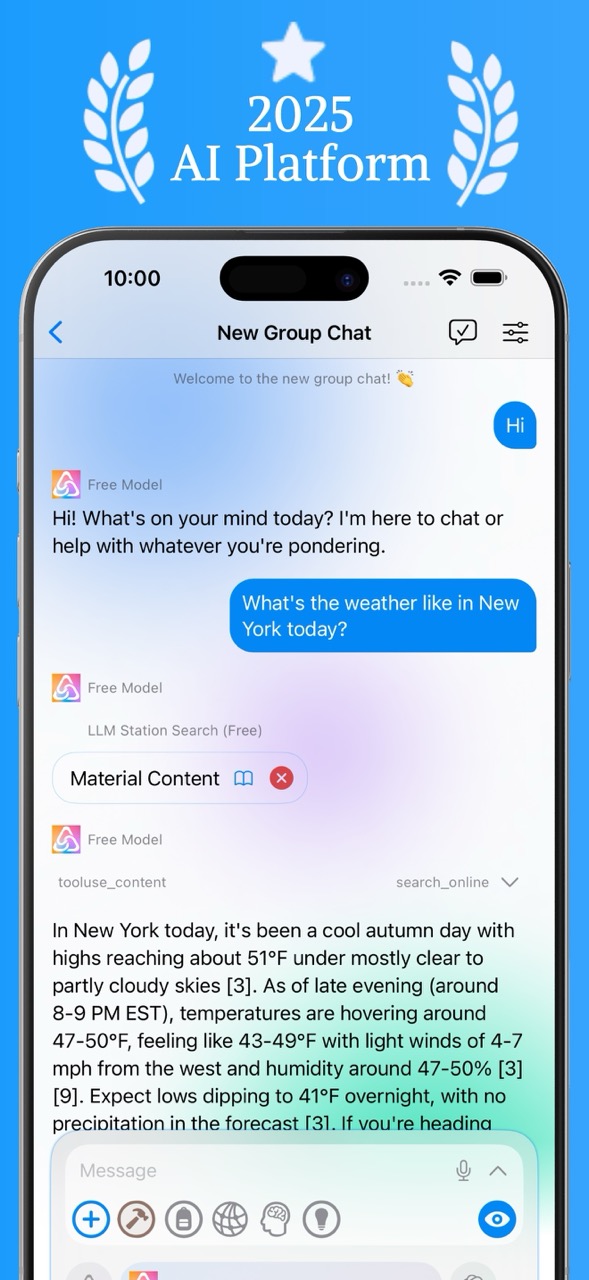
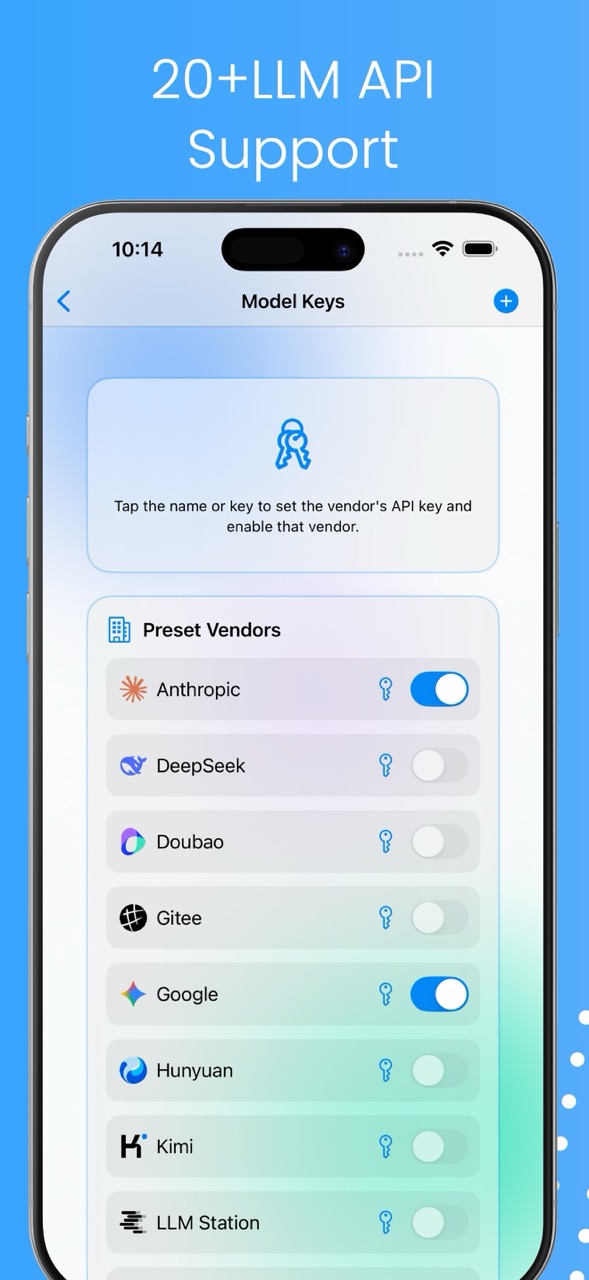
模型榜单看得越多,越难决定用哪个——因为榜单测的是别人的题目,而你要解决的是自己的问题。最靠谱的办法其实很土:同一个问题,在同一个 App 里问 5 个模型,对比着看一遍。LM Station 正好适合干这件事:它把 20+ 云端模型(GPT、Claude、Gemini、Qwen、DeepSeek 等)聚在一个 App 里,还能在 iPhone 上跑本地模型,切换模型不需要换 App、重新讲背景。
对比之前,先把问题写“可比”
跨模型对比最常见的翻车,是问题本身写得太随意。建议按这个格式准备你的测试题:背景一句话、任务一句话、输出要求一句话。例如:“我是产品经理,要给团队写一份新功能上线通知;请写一份 300 字左右的内部通知,包含上线时间、影响范围和回滚预案三个部分。”背景、任务、格式都定死了,模型的差异才会显出来;否则你对比的不是模型,而是运气。
准备两类题目效果最好:一类是你真实工作里会反复遇到的任务(写通知、做总结、列清单),一类是带“坑”的题目(需要区分概念、需要给出来源、需要承认不确定)。前者看可用性,后者看可信度——只测一类,容易得出片面的结论。
实测流程:五步跑完一轮对比
- 固定题目,逐个切换模型提问。在 LM Station 里打开对话,把同一道题分别发给 GPT、Claude、Gemini、Qwen、DeepSeek 等模型。注意不要在中途改题:改一个字,对比就不再干净。
- 先看结构,再看细节。第一遍只看每个回答的结构:有没有按你要求的三个部分组织?重点放得对不对?结构乱的回答,即使细节不错,实际用起来也要你花时间重排。
- 第二遍核对事实与边界。对带“坑”的题目,重点看模型有没有区分易混概念、有没有在不确定时明确说“不确定”、有没有给出可验证的说法。敢承认不知道的模型,往往比自信满满编答案的模型更值得托付。
- 第三遍看“可直接用”的程度。把每个回答当成草稿:哪个改动最少就能发出去?哪个需要你逐句核对?这个维度最贴近真实工作,也最容易被榜单忽略。
- 记下结论,而不是只记感觉。用一句话写下每个模型的适用场景,例如“写结构化通知首选 A,查概念辨析首选 B,长推理先看 C”。下次遇到同类任务,直接按结论选模型,不用重新跑一轮。
对比时看什么:四个维度就够了
一是结构服从度。你要求三个部分,它给了几个?顺序对不对?有没有漏掉回滚预案这类关键项。结构服从度差,意味着每次都要你当编辑。
二是事实稳健度。对需要区分的概念,它分清了没有?对不确定的内容,它是标注了不确定,还是直接给了一个看起来很肯定的答案?后者在大任务里是风险源。
三是风格匹配度。内部通知要简洁直接,对外文案要温和完整,技术总结要术语准确。风格不对的回答,即使内容对,也要重写。
四是成本与速度的体感。同一个任务,有的模型回答快但啰嗦,有的慢但一次成型。结合你自己的使用频率判断:一天问两次和一天问五十次,成本账完全不一样。LM Station 里切换模型成本很低,这正是做这种体感对比的好条件——不用为了换个模型就换 App、重新登录、重新讲背景。
别忘了本地模型这一组对照
跑完云端模型,建议再加一组本地模型对照:在 LM Station 里切换到 iPhone 本地运行的模型,用同一道题跑一遍。本地模型的意义不在于样样超过云端,而在于两个场景:断网、隐私敏感时能不能顶上;以及日常轻任务能不能不依赖网络就完成。把本地模型的回答和云端放在一起看,你会更清楚“哪些任务必须联网、哪些任务本机就够了”。
据开发者介绍,LM Station 累计下载已突破 100 万。它的价值不在于替你选出“唯一最好的模型”——这种模型不存在——而在于把切换成本降到足够低,让你能为不同任务各选一个合适的模型。
我的建议
适合谁:每天都要和 AI 打交道、但总觉得“换个模型试试”很麻烦的人;要写文档、做总结、处理多种文体任务的人;想建立自己选模型手感、而不是照搬榜单的人。跑一轮对比花不了多少时间,但能帮你省下之后无数次“这个回答怎么又要重写”的时间。
不适合谁:只偶尔问一两个问题、对回答质量没有明确要求的人——对比本身就是成本,问题越简单,对比的收益越小。另外提醒一句:对比结果只对“你这道题、这个时间点”有效,模型版本会更新,结论要定期复跑,别把一次对比当成永久答案。
换机时记忆怎么办?姊妹篇讲了长期记忆与知识库的区别和换机清单:换了新手机,AI 聊天记录和记忆能带走吗?LM Station 长期记忆与多设备用法。
下载:LM Station;官网:LM Station。也可以在 App Store 搜索“iPhone 本地大模型 App”找到它。
利益相关:LM Station 为本站团队开发的产品,本文为官方分享。