轻量级模型的赛道,又杀进了一个狠角色。11月10日,Meta正式推出Muse Ember,官方定位是“最小、最高效”的模型,专攻复杂推理和Agent高频重复的日常任务——不看参数数量,只拼性价比。
跑分追平Haiku,账单只要三分之一
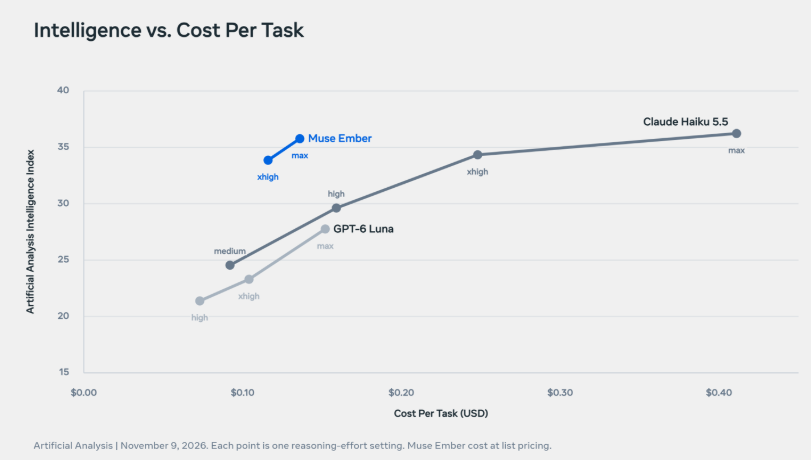
在Artificial Analysis的基准测试排行榜上,Muse Ember的综合性能已经能和Claude Haiku 5.5正面硬刚,但每次任务的成本仅为对手的三分之一。更狠的是,它在多项测试中还压过了GPT-6 Luna一头。举个例子:在端到端业务工作流AutomationBench-AA上,它得分37.8,远超Haiku的13.9和Luna的20.2。除此以外,Agent编程、长文档处理等场景也是它的强项。
一口吞下整个代码仓库
Ember拥有100万token的上下文窗口,单次输出可达51.2万token。这意味着,一次调用就能把整个代码仓库或者一摞文档完整吃进去。Agent可以在一次会话里完成成百上千个编码子任务——读文件、跑测试、定点修Bug,一气呵成。它还是一位天生的全能选手:文本、图像、音频、视频通吃,截图、图表、扫描件、会议记录、视频流……不用额外挂载其他模型就能处理。
安全方面,发布前经过Meta SI框架评估,风险低于高危红线。价格也很友好:每百万输入token仅0.10美元,每百万输出token 0.50美元。目前已经在Meta Model API、Google Cloud和Oracle Cloud上架。
客观来看,当前轻量模型战场已经卷出火星:从Phi-3到Gemini Nano,再到Qwen2.5-Coder,各大厂都在寻找“小模型大智慧”的最优解。Muse Ember的差异化在于原生多模态+超长上下文+极致性价比,三者叠加或许能帮它在Agent落地场景里杀出一条血路——毕竟,一个能吞下项目代码、还能反复Debug且不烧钱的模型,对开发者而言诱惑力十足。不过,基准测试归基准测试,真实业务中的稳定性与指令遵循能力,还得等更多实测数据说话。