先说结论:选模型不用追最强那一个,而是按任务分流——快问快答用轻量模型、深度推理和长文写作换更强的模型、涉及隐私的内容走本地模型。LM Station 把 20+ 云端模型和本地模型放在一个 App 里,正好可以按需切换,不用为每个模型单独开一份订阅。
很多人用 AI 的花销不是花在一次对话上,而是花在“所有问题都用同一个模型”上。简单的查词、改一句话,也上了最重的模型;真正需要慢慢推理的难题,反而因为怕贵而将就着用轻量模型。久而久之,要么账单变高,要么体验变差。其实问题不在模型本身,而在没有分流。
第一步:先给任务分类,再选模型
打开 LM Station 之前,先问自己一句话:这个任务要的是速度、深度、准确,还是隐私?答案不同,合适的模型就不同。
- 快问快答:查一个概念、翻译一句话、给一段话换个说法。这类任务对推理深度要求不高,优先选响应快的轻量模型,够用就好。
- 深度推理:做一道数学题、分析一份合同条款、拆解一个复杂方案。这类任务值得换更强的模型,让它慢慢想,想清楚再输出。
- 长文写作:写报告、写方案、写长篇大纲。除了模型本身的能力,还要看上下文长度够不够装下你的资料,写之前先把参考材料放进对话或知识库。
- 代码任务:写脚本、查报错、重构一段代码。选对代码表现好的模型,比反复追问同一个模型更省时间。
- 联网查证:查最新政策、最新价格、最近发生的新闻。这类问题必须联网核实,不能只靠模型的旧知识回答。
- 离线与隐私任务:日记、个人笔记、涉及隐私的草稿。这类内容优先走本地模型,不联网、不上传,写完就留在设备上。
分流的好处很直接:轻任务不浪费重模型的算力,重任务不被轻模型耽误。一个 App 里能切换模型,分类这件事才真正做得起来。
云模型和本地模型,怎么取舍?
LM Station 同时支持 20+ 云端模型(GPT、Claude、Gemini、Qwen、DeepSeek 等)和 iPhone 本地运行的大模型(Ollama/离线模型)。两者不是谁替代谁,而是各管一摊事。
云模型适合联网、推理和长上下文任务:需要查最新信息、处理大段资料、做复杂推理时,云端模型的上限更高。本地模型适合隐私和离线场景:断网的飞机上、地铁里,或者不想把内容发出去的时候,本地模型照样能用。日常使用可以这样搭配:公开资料、联网查证走云模型;私人内容、离线场景走本地模型。
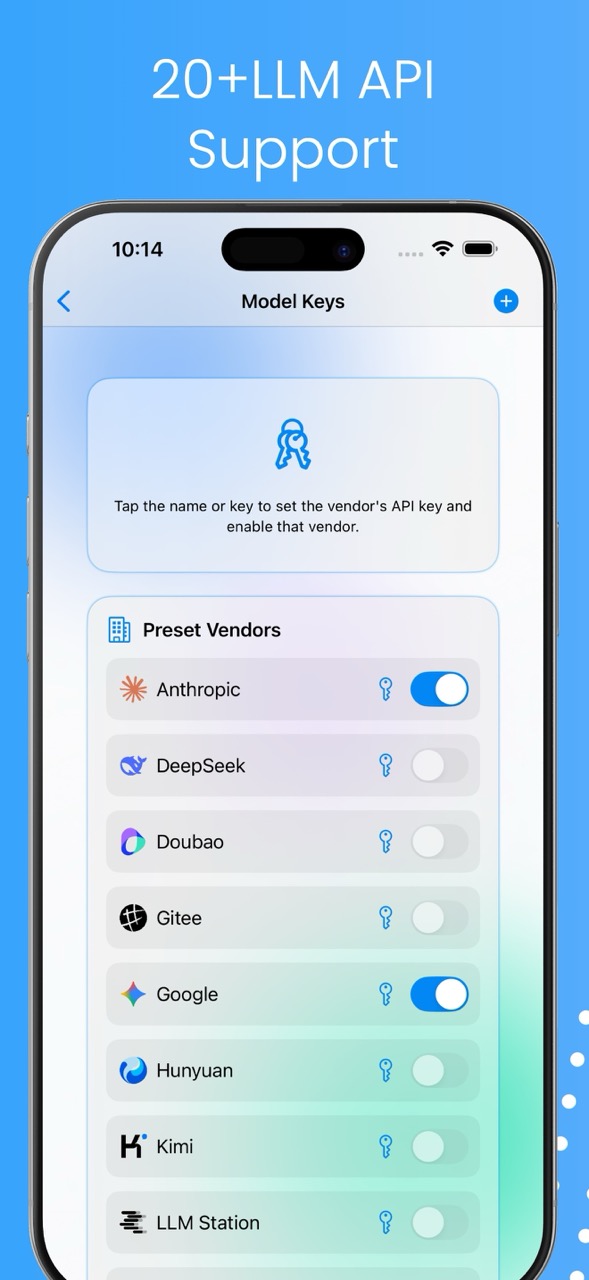
图注:模型厂商(Model Keys)配置界面——云端模型的接入与切换都在这里完成,一个 App 里管理多个模型,不用来回换应用。
关于本地模型还要说一句实话:本地模型的表现受设备和模型大小限制,不适合拿它去硬扛超长推理或超大资料处理。它的价值是隐私和离线可用,不是“什么都最强”。认清这一点,就不会对本地模型有不切实际的期待,也不会因为一次体验不好就否定它。
什么时候该换模型?四个信号
很多人一个模型用到底,不是不想换,而是不知道什么时候该换。出现下面四个信号,就值得换一个试试:
- 答案反复跑偏:同一问题追问两三次还是不对路,说明当前模型不适合这个任务,换一个模型往往比继续追问更有效。
- 任务变重了:从“帮我改句话”变成“帮我写一份完整方案”,任务升级了,模型也该跟着升级。
- 需要联网核实:问题涉及最新信息时,优先选支持联网查证或配合 Deep Research 功能的用法,先核实再下结论。
- 内容涉及隐私:写到私人信息时,停下来换成本地模型,宁可慢一点,也别把隐私内容发出去。
换模型不是“喜新厌旧”,而是给任务配最合适的工具。在 LM Station 里切换模型只需要点几下,成本低到可以养成习惯。
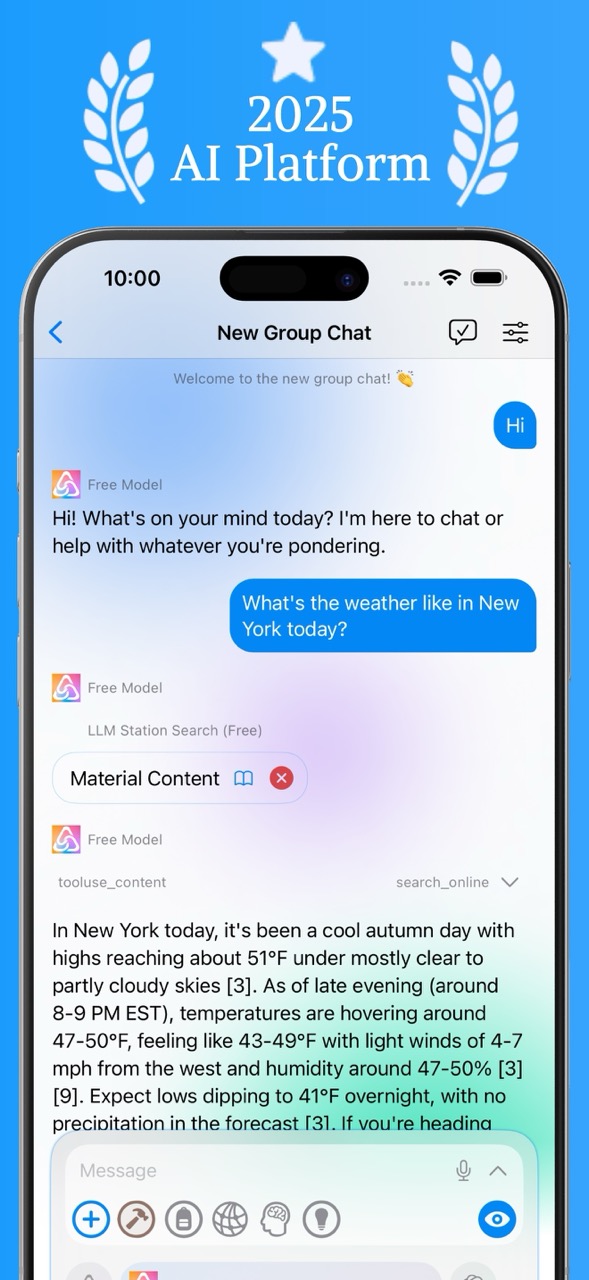
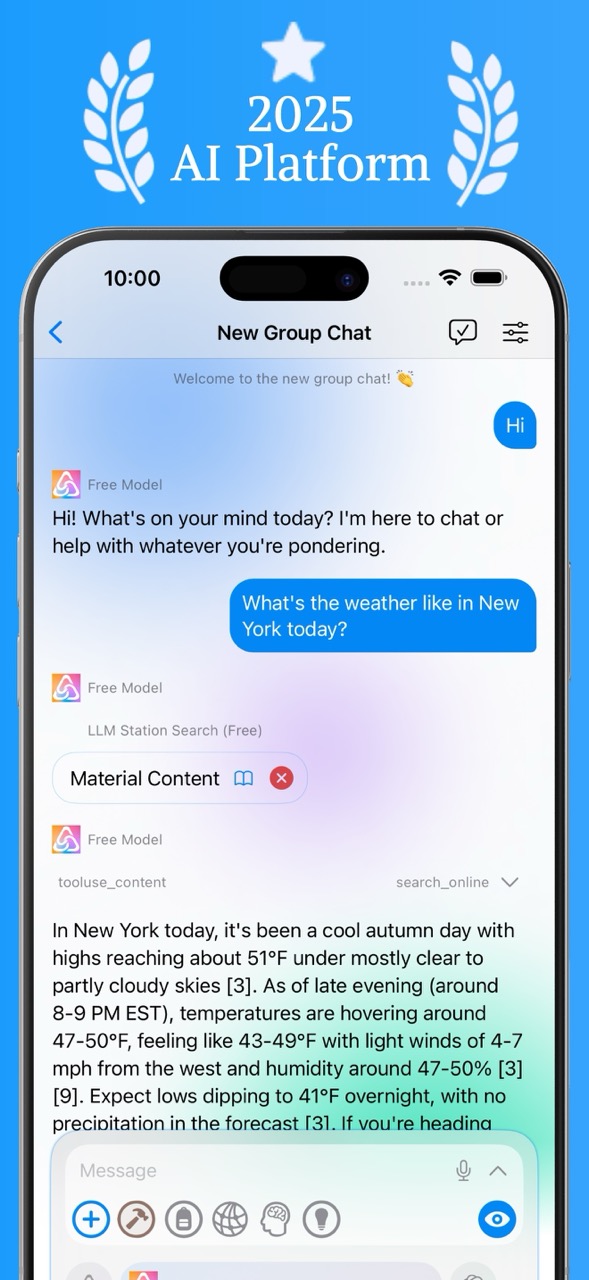
图注:主对话界面——日常提问、切换模型、查看回答都在这个界面完成,换模型不需要退出重开。
怎么用一个 App 避免多份订阅?
模型一多,最容易踩的坑就是“每个模型都开一份订阅”。最后常用的只有一两个,剩下的都在默默扣费。更省事的做法,是把调用集中到一个 App 里:
- 先列出你真正常用的任务:写作、查资料、写代码、日常问答,写下来,看看哪些是高频、哪些是偶尔。
- 按任务给模型分组:轻任务一组、重任务一组、隐私任务走本地一组,分组之后就知道自己到底需要几个模型。
- 一个 App 里切换调用:在 LM Station 里按需切换模型,用哪个开哪个,不用的不留订阅,自然就不会为闲置的订阅付钱。
- 定期复盘一次:每个月看一眼,哪个模型一个月都没打开过,就先停掉它,需要时再回来。
这套做法的核心不是“少用 AI”,而是“把钱花在真正用的地方”。模型是工具,工具箱里工具多是好事,但没必要为每个工具都单独付一份长期租金。
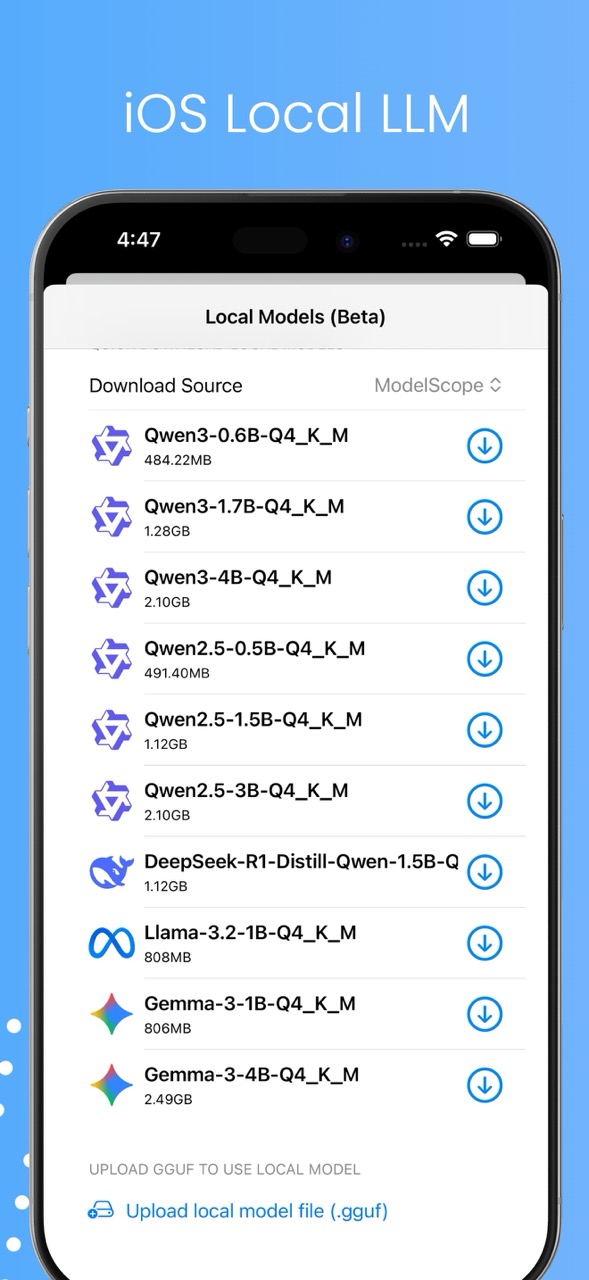
图注:本地模型列表界面——可以在 iPhone 上直接运行的离线模型在这里查看和管理,适合隐私内容和断网场景。
进阶用法:让模型搭配起来用
熟悉分流之后,还可以让不同能力搭配起来。举个例子:先用联网查证把最新资料找齐,再把资料放进 RAG 知识库沉淀下来,以后写相关内容时直接调用;写长文时用长期记忆保持上下文连贯;需要处理图片或语音时,用 LM Station 的 OCR/视觉和语音功能先把素材转成文字,再交给合适的模型处理。这篇讲的是选模型的方法,关于聚合体验本身,可以看一个 App 装下 GPT、Claude、Gemini 的聚合体验;本地模型的详细上手步骤见iPhone 本地运行大模型离线指南;写作场景的具体用法见不用订阅的 AI 写作工具实测。
一句话总结搭配逻辑:查证用联网,沉淀用知识库,隐私用本地,写作看上下文。每个环节选对工具,整体效果比单打独斗好得多。
适合谁:这份指南写给谁
这份选模型的方法,适合三类人:第一类是每天都要用 AI,但不想为多个订阅重复付钱的人;第二类是任务类型很杂的人——一会儿写代码、一会儿写报告、一会儿查资料,需要按任务换模型;第三类是对隐私比较在意的人,希望私人内容尽量留在本地设备上处理。
而不太适合的人也有:如果你只用 AI 偶尔查一两个问题,根本不需要研究分流,随便一个模型都够用;如果你已经有固定的工作流、且只用某一个模型就能覆盖全部任务,也没必要为了换而换。工具是为人服务的,分流是为了省钱省时间,不是为了增加仪式感。
想按这份方法试一试的话,可以从iPhone 本地大模型 App LM Station开始,先在同一个 App 里把轻任务、重任务和隐私任务各跑一遍,摸清自己的分流习惯。更多功能介绍见官网 LM Station 官网。
常见问题 FAQ
问:模型越多越好吗?
答:不是。模型多是选择多,但关键还是按任务分流。常用三四个模型、每个都用在合适的地方,比装了二十个却只用一个更划算。
问:本地模型能完全替代云模型吗?
答:不能。本地模型胜在隐私和离线可用,但在推理上限、长上下文和联网查证上不如云模型。两者搭配用,比只用一种更合理。
问:怎么判断一个任务该用轻量模型还是强模型?
答:看任务要的是速度还是深度。改句话、查概念用轻量模型;做推理、写长文、处理复杂资料时换更强的模型。拿不准时先用轻量模型试一轮,答案不够再升级。
利益相关:LM Station 为本站团队开发的产品,本文为官方分享。
延伸阅读
LM Station Deep Research 进阶用法:长报告跑完之后,这样验证和复用才不白跑