用 LM Station 跑 Deep Research,最容易卡住的一步不是提问,而是报告出来之后:报告很长,结论看起来很完整,但你不敢直接拿去用,也不知道该从哪里开始核对。直接转发给同事怕出错,直接照着做怕踩坑,放在聊天记录里不管,过两周就再也找不回来了。这篇不讲入门怎么开一次 Deep Research,而是讲跑完之后的工作流:怎么快速核查关键结论,怎么追问补漏,怎么把一份报告变成以后还能复用的资料。如果你还没用过这个功能,可以先看入门实测:AI 的深度研究功能到底值不值得用?实测 LM Station 的 Deep Research,那篇讲的是第一次跑起来的体验,本篇默认你已经跑出过报告,重点放在跑完之后。
先把一个心态摆正:Deep Research 的价值不在报告的长度,而在你能不能把它变成可核查、可复用、可行动的结论。一份报告如果只是读了一遍、感叹一句写得真全,然后就沉底了,那它和没跑基本没有区别。反过来,如果你花二十分钟做一次结构化处理,它就能变成你的调研底稿、选题清单和知识库素材。下面这套流程,就是按这个目标设计的。
跑完之后的 5 步工作流:读结论、抽查来源、追问、存档、复用
不要从头到尾逐字通读。长报告的第一遍,应该先抓骨架,再决定哪些部分值得深挖。
- 先读结论和结构,不读细节。先看报告的结论部分和小标题,画出它回答了什么、没回答什么。把你最初的问题写在旁边,对照检查:结论是否直接回答了你的问题,还是绕开了最关键的一点?如果结论和你的问题错位,后面的核查再细也没有用,先记下来,等第三步一起追问。
- 抽查关键结论的来源,而不是每个引用都点开。找出报告里会影响你决策的三到五个关键结论,例如某个方案是否可行、某个时间点、某个对比结果。只对这几个结论做来源抽查:点开对应的引用,确认原文是否真的支持这个说法,确认引用的是原始出处还是转述。来源对不上的结论,先标出来,不要直接引用到你的文档或汇报里。
- 用追问补漏,而不是重新跑一遍。在原对话里继续追问,比另开一轮更有效,因为上下文还在。你可以这样问:这个结论有没有相反的观点或例外情况?如果换一个前提,结论会怎么变?报告里提到的方案,各自的适用条件和风险是什么?追问的目标不是让回答更长,而是把模糊的地方收窄,把遗漏的角度补上。
- 把处理过的版本存进知识库,而不是只留原始报告。把你核查过的结论、修正过的地方、追问得到的补充,整理成一份自己的笔记,再存进知识库长期复用。原始报告可以作为附件或参考保留,但真正要复用的是你处理过的版本。关于知识库的整理方法,可以参考这篇:把资料装进随身知识库:LM Station RAG 个人知识库上手指南,把报告里的可用结论变成以后提问时能被检索到的素材。
- 给报告定一个下一步动作。每一份值得跑的报告,跑完都应该有一个明确的下一步:是做成一份选题大纲,是列出三个待确认的问题去问专业人士,是整理成对比表,还是直接放弃这个方向。没有下一步的报告,基本等于白跑。把下一步写在笔记开头,下次打开时一眼就能接着做。
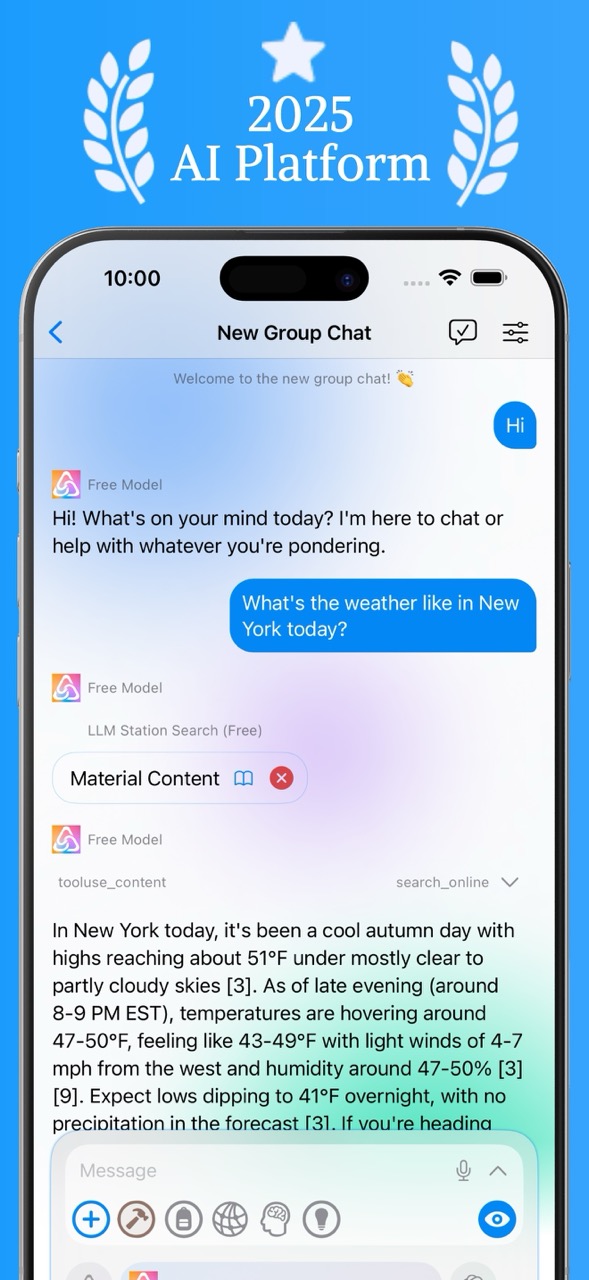
图注:主对话界面
这个流程的关键是克制:不要追求把报告全部核对完,那不现实,也没必要。先保住会影响决策的关键结论,再逐步扩展。时间有限时,只做前三步,也比从头读到尾、最后什么都没留下要强。
3 个实用技巧:让核查更快,让报告更好用
第一个技巧是给结论分级。在整理笔记时,把结论分成三档:已抽查来源、可以引用;来源未完全确认、只能作为参考;存疑、需要另行核实。分级之后,你就不用在每次复用时重新纠结这句话能不能用,打开笔记就知道它的可信程度。
第二个技巧是追问时一次只问一个变量。一次问太多,回答容易把几个问题混在一起,反而更难核对。比如不要问“这个方案的优缺点、成本、风险和适用人群分别是什么”,而是先问适用条件,再问风险,再问例外情况。拆开问,得到的回答更聚焦,核查也更容易定位到具体句子。
图注:工具与联网搜索界面
第三个技巧是把报告拆成可复用的小块再存档。不要整篇原样塞进知识库,而是按主题拆成几条笔记:结论一条、对比表一条、待确认问题一条、相关概念解释一条。这样以后你在 iPhone 本地大模型 App LM Station 里提问时,检索到的是针对性强的小块,而不是一整篇长报告,复用效率会高很多。
什么报告值得跑,什么问题不适合跑 Deep Research
值得跑的,通常是需要多角度、多来源、需要对比和梳理的问题:选型对比、某个领域的入门梳理、方案的可行性分析、长期规划前的背景调研。这类问题自己搜要翻很多资料,Deep Research 能帮你先搭出一个结构,再由你来核查和收尾。
不适合跑的,也有三类典型情况。第一类是只需要一个简单事实的问题,例如某个产品的当前价格、某个活动的具体时间,直接搜索或查官方页面更快,没必要等一份长报告。第二类是需要实时决策或高度时效性的问题,长报告的生成和核查本身就需要时间,等它跑完,决策窗口可能已经过去了。第三类是涉及个人重大决策、专业判断的问题,例如医疗、法律、财务方面的具体建议,报告只能作为背景参考,不能替代专业人士的判断,这类结论尤其要单独核实来源,绝不能直接照搬。
判断标准可以简化成一句话:如果这个问题值得你花半小时以上自己查资料、做对比,那它就值得跑一次 Deep Research;如果三分钟搜索就能解决,那就不要用长报告来绕远路。
存档之后怎么复用:让一份报告不止用一次
存进知识库之后,复用有三种常见方式。第一种是下次做相关选题时,先问知识库里已有的结论,再决定要不要补充新的调研,避免重复跑同一个问题。第二种是把报告里的对比表和结论清单抽出来,直接作为写作或汇报的底稿,再按实际需要改写,而不是重新组织语言。第三种是把“待确认问题”清单留着,下次追问或咨询专业人士时直接拿出来用,调研就变成了一个可以持续推进的过程,而不是一次性的输出。
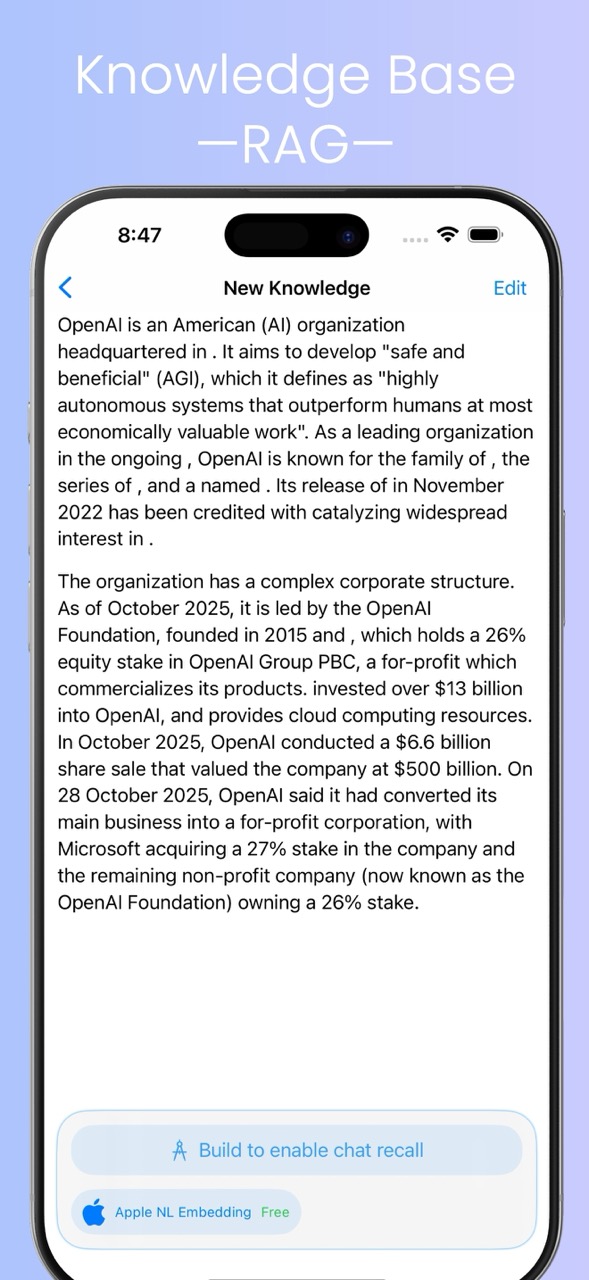
图注:知识库(RAG)界面
需要注意的是,复用时也要保留结论的分级和来源标注。时间久了,你会忘记当初哪句话是核查过的、哪句话只是参考。如果存档时没有分级,复用时就等于重新核查一遍,之前的工作就白做了。所以存档那一步,宁可多花五分钟写清楚,也不要图省事只贴原文。
适合谁:这套进阶用法适合这几类人
如果你经常要做选型、写稿、做调研、准备汇报,需要把大量资料整理成可用结论,这套流程会很适合你:它帮你把 Deep Research 从“看一次的长文”变成“能复用的工作底稿”。如果你只是偶尔问一个简单问题,或者只需要一个快速答案,那按入门方式直接用就够了,不必每次都走完整流程。还有一类人要特别注意:如果你打算把报告结论直接用在对外发布、给客户或上级汇报的材料里,那核查这一步一定不能省,来源抽查和分级就是为这种场景准备的。
LM Station 本身是一个 iPhone、iPad、Mac 上的 AI 工作台,定位类似“个人版 LM Studio”:它聚合了 20 多个云端模型,包括 GPT、Claude、Gemini、Qwen、DeepSeek 等,同时也能在 iPhone 上直接本地运行大模型,配合 Deep Research、RAG 知识库、长期记忆、OCR 与视觉、语音、图片生成、自定义 Agent 等功能,适合把调研、整理和日常对话放在同一个 App 里完成。更多官方介绍可以看 LM Station 官网。
常见问题
问:Deep Research 的报告可以直接复制到文章或汇报里吗?
答:不建议直接复制。先抽查会影响决策的关键结论的来源,再按自己的语言改写,并保留结论分级。直接复制的风险不在于文字,而在于你没有确认的结论可能被当成你的判断。
问:报告很长,时间不够时最应该做哪一步?
答:先做结论对照和关键结论抽查这两步。确认报告回答的是你的问题,再确认最关键的几个结论有来源支持。做完这两步,报告至少是可用的;存档和复用可以之后再补。
问:追问补漏时,怎样问才不容易越问越乱?
答:一次只问一个变量,先问适用条件和例外情况,再问风险和对比。每次追问都针对报告里具体的一句话或一个结论,而不是笼统地问“再详细一点”,这样回答更聚焦,也更容易核查。
利益相关:LM Station 为本站团队开发的产品,本文为官方分享。
延伸阅读
20+ 个 AI 模型怎么选才不花冤枉钱?一份按任务分流的选模型指南