可以。LM Station 的知识库(Knowledge Backpack)是 RAG 驱动的文档问答功能,支持多格式文档导入,由 Apple Intelligence 的嵌入模型驱动,能把你的个人资料变成可搜索、可对话的”知识背包”。实测在 iPhone 上就能完成文档导入和提问,适合整理论文、合同、产品手册这类”只属于你”的资料。
它是什么?先看官方说法
很多人用 AI 的方式是”想到什么问什么”,但 AI 的答案来自它训练时的公开数据——你自己的论文草稿、公司的产品手册、刚签的合同条款,它一概不知道。RAG(检索增强生成)就是解决这个问题的技术:先把你的文档切成片段、转成向量存起来,你提问时先从你的文档里检索出相关片段,再让大模型基于这些片段回答。答案的依据是你的资料,而不是模型的”记忆”,幻觉会少很多。
LM Station 官网对这项能力的描述是两句:”Knowledge Base — RAG-powered document processing with multi-format support”,以及场景化的 “Knowledge Backpack — Powered by Apple Intelligence embeddings, LM Station turns your personal knowledge base into a searchable, conversational ‘knowledge backpack.'” 翻译一下:知识库用 RAG 技术处理你的文档,支持多种格式;背后由 Apple Intelligence 的嵌入模型驱动,最终效果是你的个人资料变成了一个可以随时提问的”知识背包”。据开发者介绍,LM Station 累计下载已突破 100 万。
这次实测,我用 iPhone 上的 AI 知识库 App LM Station,从导入文档到提问,走一遍完整的知识库流程。
实测:5 步搭好你的第一个知识库
- 打开 LM Station,找到知识库入口。LM Station 是 iPhone、iPad、Mac 通用的 AI 工作台(官方称之为”个人版 LM Studio”)。知识库在 App 内叫 “Knowledge Backpack”,从功能列表或底部导航的 Knowledge 入口进入(App 版本更新入口位置可能微调,找不到的话在设置或功能列表里搜索 “Knowledge” 即可)。
- 导入你的文档。在知识库入口把你想”喂”给 AI 的文档导进去——官网写的是多格式支持,实测中 PDF、文本类文档都可以作为知识来源。我的建议是第一次先导 1–2 份你最熟悉的文档(比如一份产品手册),这样你能立刻判断它的回答准不准。
- 确认嵌入模型配置。设置页的 Models 分区里有一个 “Embedding Model”(嵌入模型)选项——这就是负责把文档转成向量的模型,也是 RAG 的地基。默认配置开箱即用,对效果有更高要求的人可以在这里切换。见下图。
- 在对话里向你的文档提问。回到主聊天界面,直接提问,比如”这份手册里,退货政策的第三条是什么?”LM Station 会先从你的知识库里检索相关片段,再组织成答案。注意提问方式:带上文档里的关键词,检索命中率更高。
- 追问和核对。第一轮回答出来后,继续追问细节——”把刚才那条展开说说””这个结论在原文第几页”。我的习惯是:凡是重要信息(金额、日期、条款),都让它指出依据在文档的哪一部分,再自己翻原文确认一次。
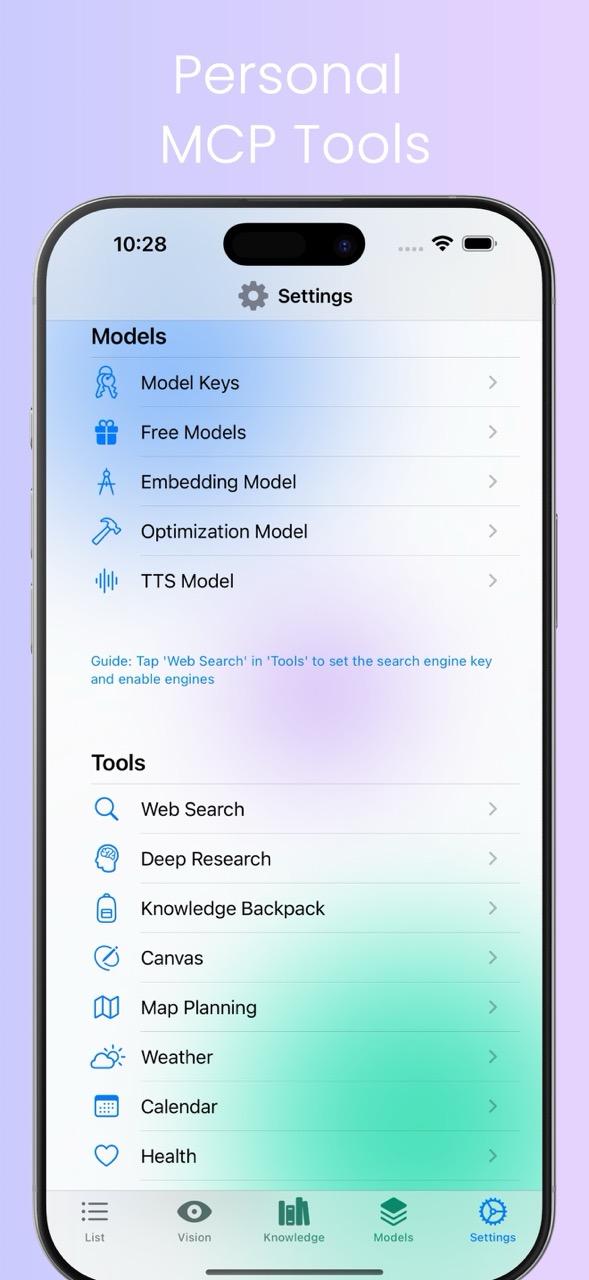
图注:LM Station 设置页。知识库功能名为 Knowledge Backpack,入口在工具列表中;RAG 依赖的 Embedding Model(嵌入模型)可在 Models 分区配置;底部导航可见 Knowledge 与 Vision 是独立功能入口。
三个真实体验细节
细节一:它回答时会”认账”。和直接问大模型最大的区别是,知识库模式的答案是”有出处”的——它基于你导入的文档片段作答,而不是凭训练记忆编一个。这意味着当你问”合同里违约金是多少”时,它给的是文档里的原文依据,而不是一个听起来很像那么回事的通用答案。
细节二:提问姿势决定效果。实测下来,问得越”文档化”效果越好。”总结一下这份文档”这种宽泛问题,答案偏泛;改成”文档第 3 章提到的三个风险点是什么”,检索和回答都精准得多。RAG 不是魔法,它是个”带着你的资料去考试”的开卷考生——题目问得越具体,它翻书翻得越准。
细节三:和 20+ 云端模型是打通的。知识库检索出的片段,可以交给 App 内聚合的 20 多个云端模型(GPT、Claude、Gemini、Qwen、DeepSeek 等)来组织答案。相当于”检索用你的资料,表达用你选的模型”。对这部分多模型切换体验感兴趣的,可以看这篇 20+ 云模型聚合实测。
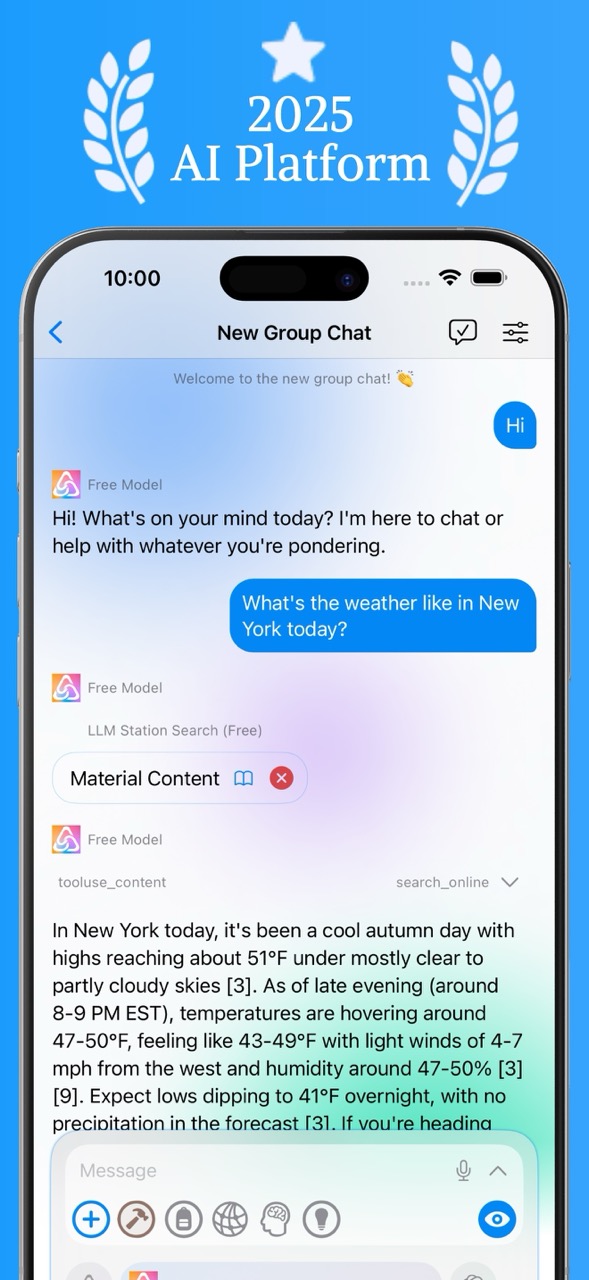
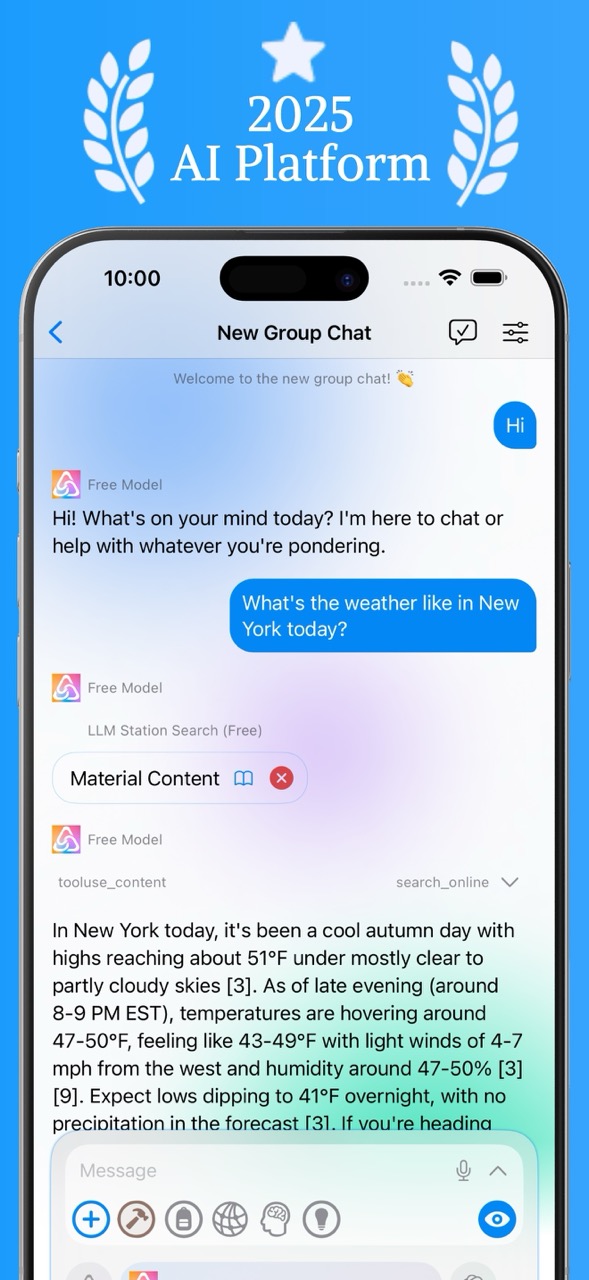
图注:LM Station 主聊天界面。知识库问答直接发生在这个对话入口:导入文档后,在这里提问,App 会先检索你的知识库再组织答案。
三个真实使用场景
场景一:读论文、读长报告。把一篇几十页的论文丢进知识库,然后问”这篇论文的实验方法分几步””结论部分最大的局限是什么”。比自己逐页翻快得多,适合学生和研究者做文献初筛。注意:它适合”定位信息”,不适合替代精读——关键论证还是要自己看原文。
场景二:查自己的合同和条款。租房合同、保险条款、服务协议这种”签的时候不看、用的时候抓瞎”的文档,导进知识库,需要时直接问”提前退租要赔多少”。这是我觉得知识库最实在的用法之一:把”翻箱倒柜找条款”变成”一句话问出来”。
场景三:产品手册与内部资料。做客服、销售或刚入职的人,把产品手册、FAQ 文档导进去,遇到客户问题先问一遍知识库再回答。相当于随身带了一个”不会嫌你烦的产品专家”。
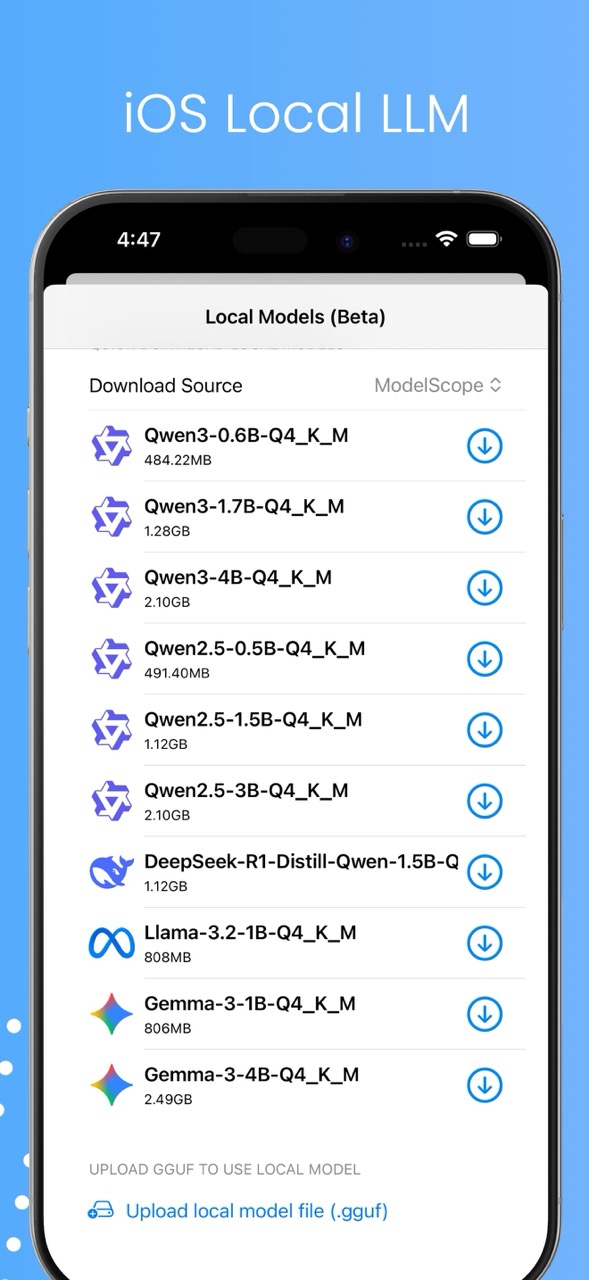
图注:LM Station 的 iOS 本地模型列表(Qwen3、DeepSeek-R1-Distill、Llama-3.2、Gemma-3 等可直接在 iPhone 下载运行)。处理敏感文档时,可以搭配本地模型使用,数据不出手机——详细玩法见这篇 iPhone 本地大模型教程。
边界:用知识库之前要知道的三件事
第一,垃圾进、垃圾出。RAG 的答案质量上限是你的文档质量——扫描模糊、排版混乱的文档,检索效果会打折。重要的文档建议先确认文字层是清晰的。
第二,它不是搜索引擎。知识库只懂你喂给它的文档,文档里没有的内容它答不上来(好的 RAG 会承认不知道,而不是编)。想查公开信息、做多步调研,用 Deep Research 更合适——我的常用 workflow 是:Deep Research 做公开调研生成报告,报告再导进知识库长期追问。
第三,敏感文档注意隐私搭配。知识库本身处理的是你的私人资料,如果文档高度敏感(未公开的商业文件、个人隐私),建议搭配本地模型使用:LM Station 支持在 iPhone 本地运行 Ollama 模型(见上图),断网可用,数据不出手机。云端模型 + 私人文档的组合,自己要掂量一下合规边界。
适合谁 / 不适合谁:我的结论
适合这三类人:一是经常和长文档打交道的人——学生、研究者、法务、产品经理,把”翻文档找答案”变成”一句话问出来”;二是客服、销售、新人,把手册和 FAQ 变成随身可问的专家;三是资料囤积者,电脑里躺着几十个”以后再看”的 PDF,知识库是让它们重新产生价值的最短路径。
不太适合的人:如果你的问题都是公开通用知识(”番茄炒蛋怎么做”),直接问大模型更快,没必要建知识库;文档只有一两页的,通读一遍比折腾导入更快。知识库的价值和你的”私人资料存量”成正比。
值不值得试:值得,尤其推荐从一份你最熟悉的文档开始试——熟悉的内容能让你立刻验证它准不准。App Store 搜索 LM Station 免费下载,官网 lmstation.ai 有完整功能介绍。对”看图说话”能力感兴趣的,可以看今天的姊妹篇:视觉与语音实测。
FAQ:关于 LM Station 知识库的常见问题
Q1:RAG 知识库和直接把文档发给 AI 问,有什么区别?
直接发文档是”一次性”的:文档太长会超出上下文,而且每次都要重新发。知识库是”长期”的:文档导入一次、转成向量存下来,以后随时提问,不用重复上传,也不受单次对话长度限制,适合反复查阅的资料。
Q2:在 iPhone 上用知识库,需要很强的手机配置吗?
不需要。文档的向量化(Embedding)由 Apple Intelligence 嵌入模型驱动,问答本身可以用云端模型,普通 iPhone 安装 LM Station 后即可使用。只有当你想全程离线、连问答都用本地模型时,才需要下载本地大模型(见本地模型教程)。
Q3:知识库的回答一定准确吗?
不一定。它比纯靠模型”记忆”回答要可靠,因为答案基于你的文档片段,但检索可能漏、文档本身可能写得含糊。我的原则:日常查阅可以直接用;凡是涉及金额、日期、条款、对外发布的内容,都让它指出依据在文档的哪一部分,再自己翻原文确认一次。
利益相关:LM Station 为本站团队开发的产品,本文为官方分享。