大模型推理这门”烧钱的手艺”,DeepSeek 把自家家伙事儿开源了
聊大模型,大家的注意力都在”模型有多强”上,但真正烧钱的是另一头:推理。一个模型发布之后,每一次调用都要过推理引擎这一关——吞吐上不去,API 成本就下不来;延迟压不住,用户体验就起不来。DeepSeek 之所以能把 API 价格打到让全行业难受,靠的不只是模型本身,还有它背后那套为 MoE 架构深度定制的推理框架。
10 月 16 日,DeepSeek 官方把这套东西开源了:DeepInfer(deepseek-ai/DeepInfer)——README 第一句话就写明,这是”支撑 DeepSeek 大规模生产服务的推理框架”。开源 8 天拿下 2.1 万 star,登上 GitHub Trending,是本周 AI 圈最热的开源事件之一。下面按我读 README 和仓库一手信息的理解,拆开讲讲它到底是什么、强在哪,以及——先说清楚——它不是给个人电脑准备的。
它是什么:DeepSeek 生产服务的”发动机”开源版
一句话:DeepInfer 是 DeepSeek 自家线上大规模服务的推理引擎的开源版本,提供离线推理和服务化所需的核心特性,当前支持的模型是 DeepSeek-V4.1-Flash。它的技术底子主要来自 vLLM(README 明确致谢),同时吸收了 SGLang 和 TensorRT-LLM 的思路——相当于站在三个主流推理框架肩膀上,再按 DeepSeek 自己的 MoE 架构做了深度定制。核心亮点有这么几个:
1. 全套自研优化算子:DeepSeek 推理快的底牌之一。 FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect,再加上用 TileLang 写的自定义算子。这些名字过去只出现在 DeepSeek 的技术报告里,现在连实现一起开源了。对做推理优化的人来说,这相当于拿到了”参考答案”——别人是怎么把 MLA 注意力、MoE 专家并行做到极致的,代码里写得明明白白。
2. DSpark + 置信度调度验证:推测解码的 DeepSeek 式做法。 原理是用小代价先生成一批”草稿 token”,再用主模型批量验证,猜对了就白赚速度。DeepInfer 的做法是按置信度来调度验证节奏(DEEPINFER_ENABLE_MTP_VARLEN=1 开启,草稿长度默认 5)。推测解码这两年各家都在做,DeepSeek 把自家生产验证过的版本放出来,工程参考价值很高。
3. 为 MoE 量身定制的并行策略。 MoE 模型推理真正的难点不在算力,在”专家”怎么分、负载怎么匀。DeepInfer 给了 Attention DP / balanced CP、MoE EP + EPLB(专家并行 + 负载均衡)这套组合。这也是它和通用推理框架最大的区别:vLLM 要照顾所有模型,DeepInfer 只为 DeepSeek 自己的 MoE 架构调到最优。
4. 工程确定性:batch-invariant 推理与确定性采样。 同样的输入、不同的 batch 组合,结果完全一致;固定随机种子,采样输出逐字可复现。听起来不起眼,但这是生产环境的刚需——线上排障、效果评测、回归测试,没有确定性寸步难行。很多开源推理方案恰恰缺这一块。
5. 结构化输出:Agent 场景的刚需。 支持按正则、JSON Schema 或 EBNF 文法约束模型生成。做 Agent、做数据抽取、做工具调用的人都懂:让模型”必须输出合法 JSON”这件事,靠提示词是赌运气,靠解码期约束才是工程。
也要诚实地说它的边界:README 明确列了”本次不包含”的三样东西——KV cache 系统、VE/Prefill/Decode 解耦、跨数据并行副本的负载均衡。也就是说,它不是开箱即用的完整生产服务,拿来做大规模 serving 还得自己补几块拼图。DeepSeek 开源的是”发动机”,不是”整车”。
截图导览
图注 1:DeepInfer 的 GitHub 仓库分享卡(deepseek-ai/DeepInfer)。项目名与简介一目了然——官方定位非常直接:这就是 DeepSeek 生产级推理框架的开源版(star 数 21,117 为 2026-10-24 在仓库主页看到的数据)。
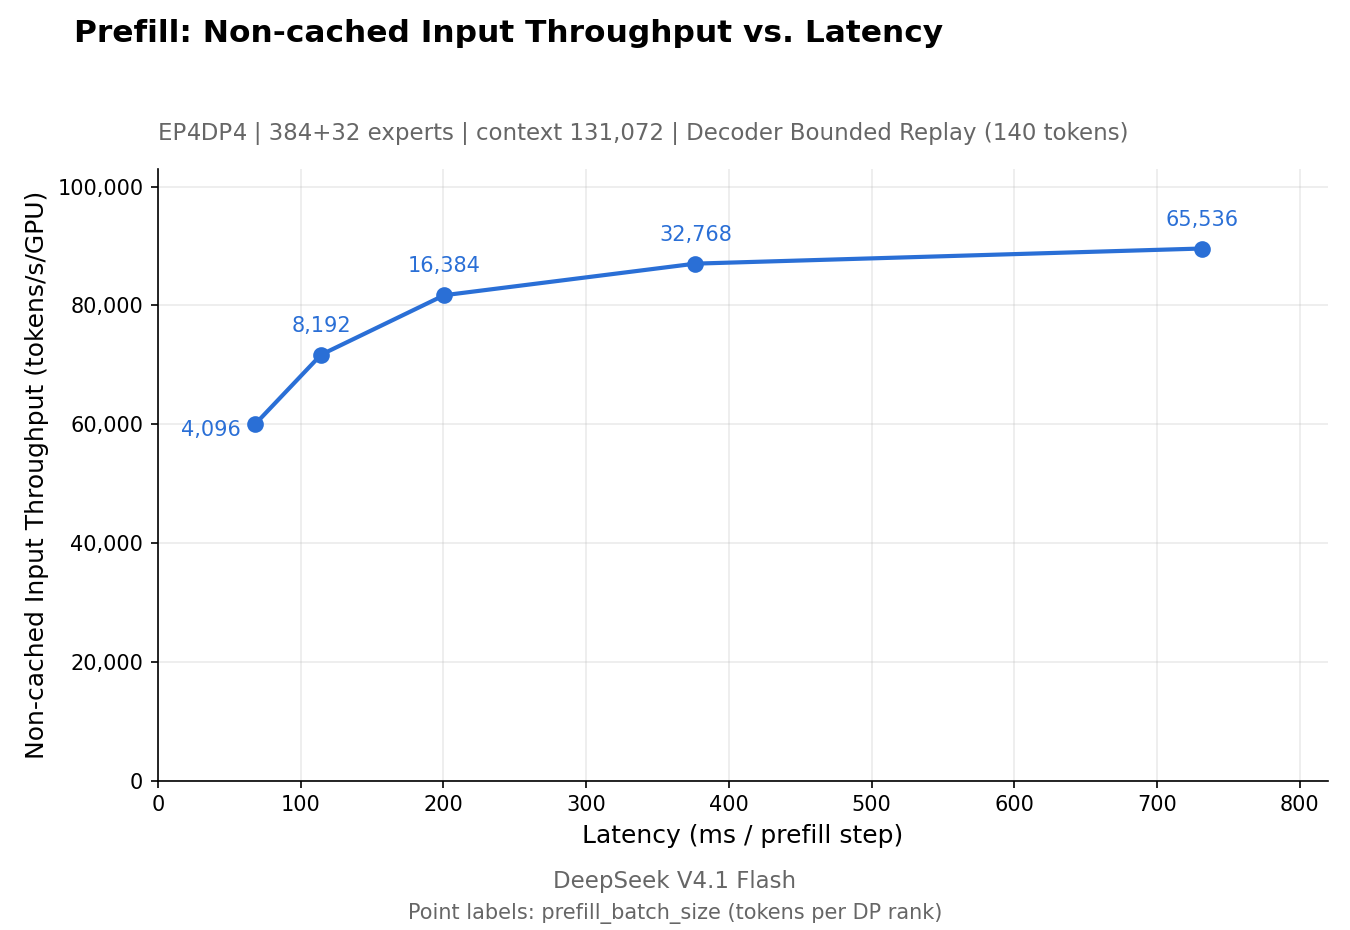
图注 2:README 里的官方基准图——Prefill 阶段吞吐 vs 延迟曲线,在 4 张 SM100 GPU 上实测。这是评价推理框架的关键指标:同样的延迟预算下,能多”喂”进去多少 token,直接决定 API 成本。
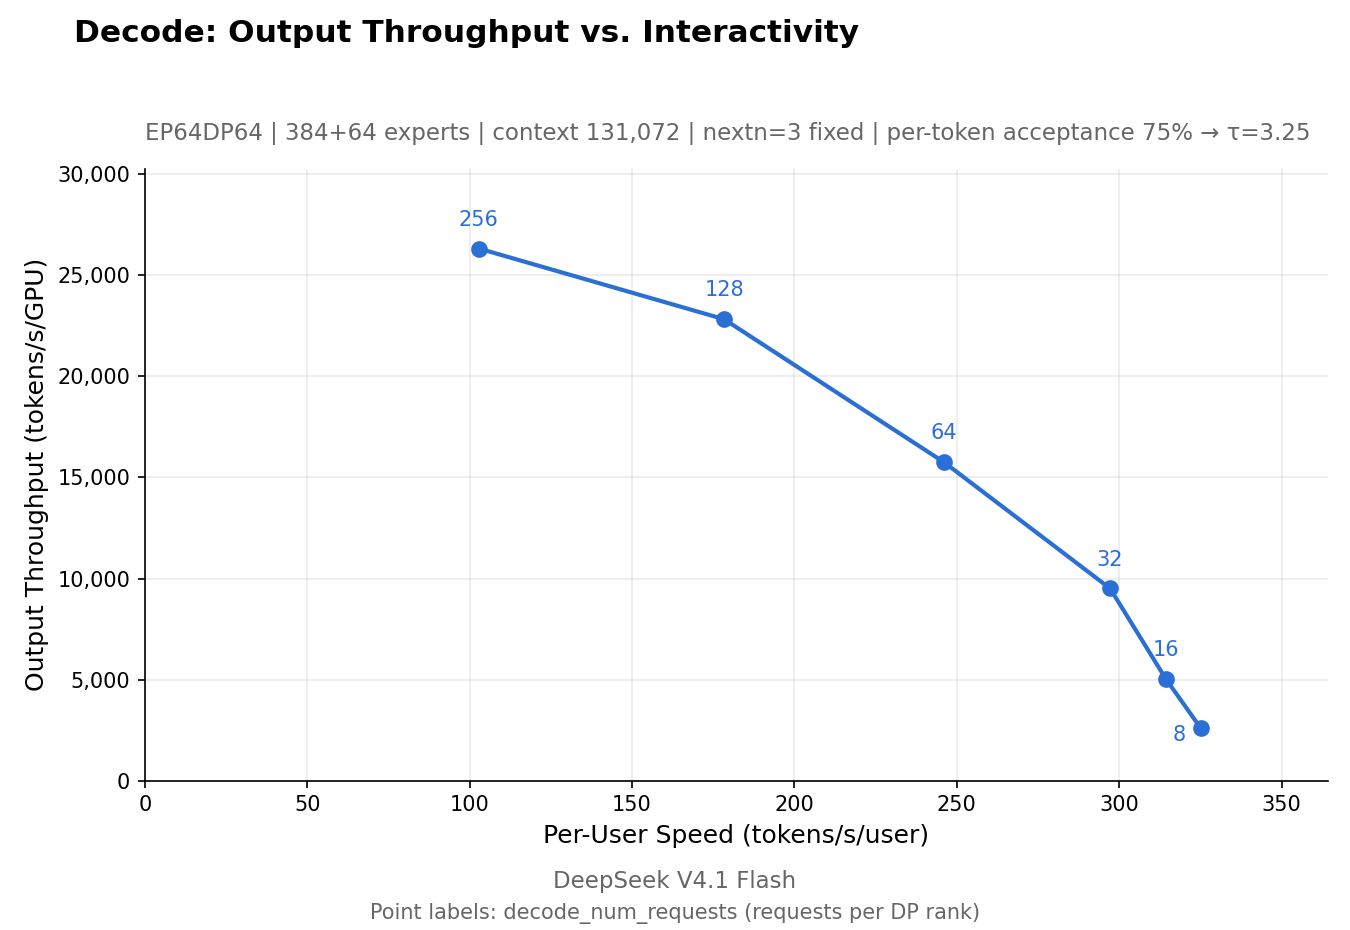
图注 3:README 里的官方基准图——Decode 阶段输出吞吐 vs 单用户速度曲线,在 64 张 SM100 GPU 上实测。Decode 阶段决定用户打字机效应的流畅度,这张图展示的是大规模并发下的输出能力。
快速上手:步骤不复杂,门槛全在硬件
先说结论:安装步骤本身不复杂,但 99% 的个人读者会被硬件门槛拦住——这是 README 写得最实在的地方,我原样转述:
硬件要求(README 原文):NVIDIA SM100 GPU,或华为昇腾 950 NPU。 翻译一下:SM100 是 NVIDIA Blackwell 架构的数据中心 GPU(B200/GB200 这一级别),昇腾 950 也是数据中心 NPU。你的 RTX 4090、MacBook,不在支持列表里。这不是”跑得慢”的问题,是”官方只适配了这两种”的问题。
如果你恰好有这样的机器,流程是这样的(照 README 原文):
环境准备:Linux 系统,GCC >= 13.0,Python 3.12,NVIDIA 平台装 CUDA 13(昇腾平台装 CANN 9.2)。
从源码构建:
export DEEPINFER_ACCELERATOR=nvidia(昇腾平台把 nvidia 换成 ascend,这个变量要在运行环境中一直保持导出)
./build.sh
跑离线推理:
python examples/offline_inference.py
模型权重不用手动找:默认 checkpoint 是 deepseek-ai/DeepSeek-V4.1-Flash-1017,第一次运行时自动从 Hugging Face 下载到本地缓存;如果你已经有权重,设 DEEPINFER_HF_MODEL_DIR 指向本地路径即可。更多用法去看仓库的 examples 目录和 eval/README.md(评测相关)。
另外注意:仓库目前没有任何 Release 和 Tag,只有 main 分支的 4 个 commit——这是非常早期的开源状态,API 和行为都可能随时变。拿来生产用,要有跟随上游更新的心理准备。
我的建议:谁该看,谁先别折腾
先说结论:DeepInfer 是本周最值得”读”而不是最值得”装”的开源项目——除非你手里有数据中心级的卡。 理由拆开说:
适合这三类人。第一,有 B200/GB200 或昇腾 950 资源的团队和云厂商。 这是 DeepSeek 官方出品、Apache-2.0 宽松协议的生产级框架,目标就是帮你把 DeepSeek-V4.1-Flash 跑出 DeepSeek 官方同款的效率。做 DeepSeek 模型服务化的,这几乎是必看的选项。第二,做推理优化、infra 方向的工程师。 哪怕你一时半会儿用不上,FlashMLA、DeepEP、EPLB、DSpark 这些生产验证过的实现,是市面上能读到的最顶级的 MoE 推理”参考答案”,比看论文实在得多。第三,跟踪 DeepSeek 技术路线的研究者和爱好者。 从 V3 的 DeepEP 到 V4.1-Flash 的 DeepInfer,DeepSeek 正在把”推理优化”这件事系统性地开源出来,读懂它就读懂了 DeepSeek 成本优势的一半来源。
这三类人先别折腾。第一,只有消费级显卡或 Mac 的个人用户——README 只支持 SM100 和昇腾 950,你的机器连构建目标都不满足,硬上是浪费时间。想本地跑 DeepSeek 模型,老老实实用 Ollama/vLLM 的社区量化版。第二,只想”一键跑个模型聊天”的人——这是给服务化用的框架,不是开箱即用的应用,它连 KV cache 系统都没包含,指望”装完就能对话”会失望。第三,指望它替代完整生产方案的人——prefill/decode 解耦、负载均衡这些还要自己补,它目前是个高质量的”发动机”,不是”整车”。
还有一句实在话:8 天 2.1 万 star 里,大部分人是来”围观学习”的,不是来”部署上线”的——这很正常,也是它最大的价值。 过去这一年,DeepSeek 用技术报告告诉行业 MoE 该怎么做,现在它开始用开源代码告诉行业推理该怎么做。对普通读者,我的建议是:star 它,把 README 的特性列表读一遍,理解”推测解码””专家并行负载均衡””batch-invariant”这些概念解决的是什么问题——这些认知,在你以后选推理方案、用云厂商 API 时都用得上。
GitHub 仓库:github.com/deepseek-ai/DeepInfer(Apache-2.0 开源)。动手前先看一眼 README 的硬件要求,确认自己的机器在支持列表里再行动。
延伸阅读
同样是”把大厂能力搬到本地”的思路,昨天分享的 VoiceStudio 是把云端 TTS/声音克隆做成了完全本地的桌面应用,8 万 star,普通人电脑就能跑——和今天这个”数据中心专属”的 DeepInfer 正好是两个极端,对照着看很有意思。
如果你关注的是 Agent 侧的工程优化(比如长上下文窗口的压缩),可以看看我们之前分享的 Headroom:给 AI Agent 做的上下文压缩工具,解决的是另一头的成本问题——一个管”想得明白”,一个管”算得便宜”。